Сравнение Ollama и llama.cpp на одном GGUF (Ollama vs llama.cpp benchmark defaults) часто заканчивается фразой «один движок быстрее другого», хотя причина обычно в другом. Автор разбора на dev.to сравнил два рантайма на одном файле и получил разрыв около 15%, а потом показал, что он почти целиком состоял из настроек по умолчанию. Эта статья переносит методику на CPU и малую модель. Вы получите стенд, где два сервера читают один и тот же GGUF, скрипт замера и правила, по которым можно не обмануть самого себя.
О чём исходник и что в нём главное
Исходник под названием Ollama vs. llama.cpp on the Same GGUF описывает замер на ноутбуке Surface Laptop Ultra с GPU. Модель Qwen3.6-35B-A3B в квантовании Q4_K_M запускали в приложении Ollama 0.40.7 и в приложении Llama-Windows 0.13.0 от разработчиков llama.cpp. Контекст был одинаковый, 262144 токена, а промпт один.
С настройками как поставлено Llama-Windows показал около 85% скорости Ollama. Автор сначала решил, что виноват движок, но Ollama внутри сама запускает llama-server из llama.cpp, причём по данным исходника встроенная сборка отличалась от сборки Llama-Windows всего на 32 коммита. Тогда он нашёл два расхождения в дефолтах. Первое, Ollama по умолчанию включает спекулятивное декодирование (speculative decoding) через MTP (multi-token prediction, предсказание нескольких токенов), а именно угадывает 2 токена вперёд. Второе, значения сэмплинга (sampling) у моделей Ollama и у llama.cpp разные.
После выравнивания обоих пунктов скорости сравнялись. Остался один эффект, при presence_penalty 1.5 только сторона llama.cpp замедлилась примерно на 7%, причину автор не выяснял. Ещё он отметил, что при фиксированном seed пять прогонов дают один и тот же текст, поэтому разброс из-за разных ответов в замер не попадает. Всё это измерено на одном промпте и одном ноутбуке, и вывод стоит читать именно так.
Нам из этого нужна не цифра 15%, а методика. Ниже мы разберём, что именно выравнивать, как читать метрики двух серверов и как повторить проверку на CPU.
Почему сравнение двух рантаймов на одном GGUF легко сделать неправильно
Одинаковый файл весов не означает одинаковых условий. Между файлом и первым токеном лежит слой настроек, который каждый рантайм накладывает по-своему. Если его не трогать, вы сравниваете не движки, а чужие решения о том, как их запускать по умолчанию.
Ollama тоже запускает llama.cpp
Ollama не самостоятельный вычислитель, а оболочка со своим менеджером моделей, API и набором параметров. Поэтому вопрос «что быстрее» корректнее звучит как «какие настройки применяются в каждом случае». Различие в версиях сборки возможно, но подозревать его стоит после настроек. Автор исходника сообщает, что встроенная в Ollama сборка новее сборки Llama-Windows на 32 коммита. На нашем стенде мы фиксируем версии и печатаем их в начале прогона.
Таблица дефолтов
В таблице собраны значения из документации Ollama (страницы Modelfile и FAQ) и из README llama-server. Параметры конкретной модели в Ollama могут переопределять общие значения, поэтому в практике мы читаем их командой показа параметров, а не берём из таблицы на веру.
| Критерий | Ollama | llama-server (llama.cpp) |
|---|---|---|
| temperature | 0.8 по документации Modelfile, модель может задать своё | 0.80 |
| top_k | 40 | 40 |
| top_p | 0.9 | 0.95 |
| min_p | 0.0 | 0.05 |
| presence_ |
нет в таблице параметров Modelfile, модель может принести значение (в исходнике 1.5 у Qwen3.6) | 0.00, то есть выключен |
| repeat_penalty | 1.0, выключен | 1.00, выключен |
| seed | 0 по документации | -1, случайный |
| Контекст | 4096 токенов по FAQ, меняется через num_ctx или OLLAMA_ |
0, то есть берётся из модели, меняется флагом -c |
| Спекулятивное декодирование | параметр draft_ |
возможность сервера, включается отдельными флагами |
| Источник метрик скорости | eval_count и eval_duration в ответе API | поле timings. |
| Как переопределить | options в запросе или PARAMETER в Modelfile | поля запроса или флаги и переменные окружения LLAMA_ARG_* |
По документации расходятся только часть значений. Отличаются top_p и min_p, а также seed и presence_penalty, тогда как temperature, top_k и repeat_penalty совпадают. Но общие значения Ollama может заменить параметрами конкретной модели. На нашем стенде так и вышло. Вывод показывает, что для qwen3:0.6b сама модель задаёт temperature 0.6, top_k 20 и top_p 0.95. Поэтому реальные значения нужно брать из вывода параметров модели, а не из таблицы документации. В режиме «как поставлено» серверы могут выбирать токены из разных множеств, и даже здесь разрыв может оказаться не про движок.
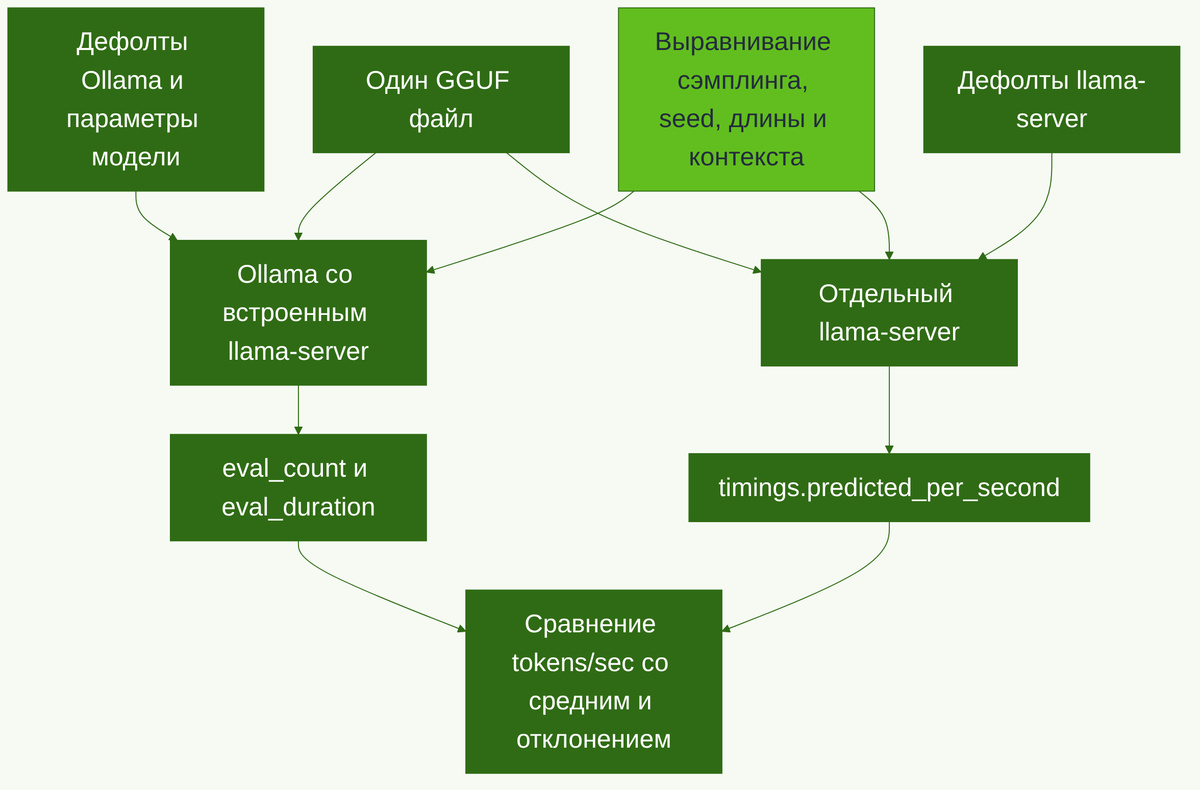
Что выравнивать и как читать метрики
Схема выше сводит порядок работы к одному правилу. Сначала снимаются все различия, которые вы контролируете, и только потом смотрится остаток.
Что выравнивать
Минимальный список, который мы применяем в практике, такой.
- Сэмплинг. Явно передаём temperature, top_k, top_p, min_p, presence_penalty и repeat_penalty в каждом запросе к обоим серверам, а не надеемся на дефолты.
- Seed. Фиксируем одно значение. Но при этом несколько прогонов дают один и тот же текст, и разброс по разным ответам остаётся за рамками замера, как и в исходнике.
- Длина генерации. Ограничиваем её одинаково, num_predict в Ollama и max_tokens в llama-server. Это защита от ситуации, когда один сервер просто написал короче.
- Контекст и параллелизм. Задаём num_ctx 4096 у Ollama и -c 4096 у llama-server, а число слотов сервера ставим в 1 флагом -np.
- Спекулятивное декодирование. Либо включаем с обеих сторон, либо выключаем с обеих.
Если пропустить любой из пунктов, получится разница в проценты, которая не говорит ничего о движке. Наш прогон ниже показывает, что даже при выравнивании на коротком замере знак разрыва может меняться от режима к режиму.
Как читать метрики двух серверов
Ollama возвращает в ответе eval_count, число сгенерированных токенов, и eval_duration в наносекундах. Скорость считается как eval_count, делённое на eval_duration в секундах. У llama-server то же значение лежит готовым в поле timings.predicted_per_second. Обе метрики описывают только фазу генерации, без обработки промпта, поэтому сопоставимы. Если модель рассуждает, токены размышлений входят в число, как и в исходнике.
Одного прогона недостаточно. Мы делаем один прогрев, потому что первый запрос включает загрузку модели, и затем три замера с выводом среднего и стандартного отклонения. Вместе со скоростью печатаем число токенов в каждом прогоне. Если оно различается между серверами, разница в скорости может быть просто разницей в тексте, и сравнивать её как скорость движка нельзя.
Про облачные ориентиры. GigaChat и YandexGPT доступны только через API, на стенд они не помещаются, а метрики там совсем другие. Любопытная деталь, в README llama-server среди встроенных шаблонов чата есть gigachat, yandex, kimi-k2 и deepseek, то есть движок умеет форматировать промпты в стиле этих семейств. Мы же проверяем методику на модели Qwen3 0.6B, а тот же скрипт работает и с дистиллятом DeepSeek-R1, это задание ниже.
Практика. Бенчмарк Ollama и llama-server на одном GGUF
Стенд состоит из двух контейнеров. Ollama скачивает модель qwen3:0.6b, затем скрипт кладёт ссылку на её GGUF в общую папку. Второй контейнер, llama-server, читает тот же файл. Тег образа llama.cpp плавающий, поэтому его сборку скрипт замера выводит из ответа сервера. На клиенте нужен только Python с библиотекой httpx, о базе языка можно прочитать в курсе Основы Python для анализа данных и ML.
Сначала описание сервисов. Порты открыты только на 127.0.0.1, память ограничена, суммарно 5 ГБ.
# compose.yaml · ollama/ollama 0.40.13 · ghcr.io/ggml-org/llama.cpp server b12033
services:
  ollama:
    image: ollama/ollama:0.40.13
    mem_limit: 3g
    ports:
      - "127.0.0.1:${OLLAMA_PORT:-21434}:11434"
    volumes:
      - ollama_data:/root/.ollama
  llama:
    image: ghcr.io/ggml-org/llama.cpp:server
    mem_limit: 2g
    ports:
      - "127.0.0.1:${LLAMA_PORT:-28080}:8080"
    volumes:
      - ollama_data:/models:ro
    command: ["-m", "/models/${GGUF_NAME:-qwen3-0.6b.gguf}", "-c", "4096", "-np", "1", "--host", "0.0.0.0", "--port", "8080"]
volumes:
  ollama_data:
Зависимость у клиента одна.
# requirements.txt
httpx==0.28.1
Скрипт запуска поднимает Ollama, скачивает модель, достаёт путь к GGUF из вывода команды показа Modelfile и создаёт ссылку на файл в общей папке. Только после этого стартует llama-server, иначе ему нечего было бы читать. Стенд скрипт не гасит.
#!/usr/bin/env bash
# run.sh · Docker Compose · Ollama 0.40.13
set -euo pipefail
export MODEL_TAG="${MODEL_TAG:-qwen3:0.6b}"
export GGUF_NAME="${GGUF_NAME:-qwen3-0.6b.gguf}"
export OLLAMA_PORT="${OLLAMA_PORT:-21434}"
export LLAMA_PORT="${LLAMA_PORT:-28080}"
docker compose up -d ollama
until curl -sf http://127.0.0.1:$OLLAMA_PORT/api/version >/dev/null; do sleep 2; done
docker compose exec -T ollama ollama pull "$MODEL_TAG"
docker compose exec -T ollama sh -c "blob=\$(ollama show --modelfile $MODEL_TAG | sed -n 's/^FROM //p' | head -n1); ln -sf \"models/blobs/\$(basename \"\$blob\")\" /root/.ollama/$GGUF_NAME"
docker compose up -d llama
until curl -sf http://127.0.0.1:$LLAMA_PORT/health >/dev/null; do sleep 2; done
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python bench.py
Теперь основной скрипт. Он описывает три режима. В режиме defaults мы не передаём ни одного параметра сэмплинга, кроме длины и контекста. В режиме aligned оба сервера получают одинаковые значения и seed 42. В режиме greedy температура равна нулю, то есть всегда выбирается самый вероятный токен.
# bench.py · httpx 0.28.1 · Ollama 0.40.13 · llama.cpp server b12033
import os
import statistics

import httpx

OLLAMA = f"http://127.0.0.1:{os.environ.get('OLLAMA_PORT', '21434')}"
LLAMA = f"http://127.0.0.1:{os.environ.get('LLAMA_PORT', '28080')}"
MODEL = os.environ.get("MODEL_TAG", "qwen3:0.6b")
PROMPT = "Объясни тремя предложениями, что такое кэш процессора."
MAX_TOKENS = 96
CTX = 4096
RUNS = 3

ALIGNED = {
    "temperature": 0.6,
    "top_k": 20,
    "top_p": 0.95,
    "min_p": 0.0,
    "presence_penalty": 0.0,
    "repeat_penalty": 1.0,
    "seed": 42,
}
GREEDY = {**ALIGNED, "temperature": 0.0}
MODES = {"defaults": {}, "aligned": ALIGNED, "greedy": GREEDY}


def ollama_run(params, extra=None):
    options = {"num_predict": MAX_TOKENS, "num_ctx": CTX, **params, **(extra or {})}
    body = {
        "model": MODEL,
        "messages": [{"role": "user", "content": PROMPT}],
        "stream": False,
        "options": options,
    }
    data = httpx.post(f"{OLLAMA}/api/chat", json=body, timeout=900).json()
    speed = data["eval_count"] / (data["eval_duration"] / 1e9)
    return data["eval_count"], speed


def llama_run(params, extra=None):
    body = {
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": MAX_TOKENS,
        "stream": False,
        **params,
        **(extra or {}),
    }
    data = httpx.post(f"{LLAMA}/v1/chat/completions", json=body, timeout=900).json()
    return data["usage"]["completion_tokens"], data["timings"]["predicted_per_second"]


def measure(fn, params, **kwargs):
    fn(params, **kwargs)
    runs = [fn(params, **kwargs) for _ in range(RUNS)]
    speeds = [speed for _, speed in runs]
    tokens = [count for count, _ in runs]
    return statistics.mean(speeds), statistics.stdev(speeds), tokens


def report(mode, engine, mean, sd, tokens):
    print(f"{mode:20} {engine:8} {mean:7.2f} +- {sd:5.2f} tok/s  tokens={sorted(set(tokens))}", flush=True)


def describe():
    print("ollama", httpx.get(f"{OLLAMA}/api/version", timeout=30).json().get("version"))
    print("llama build", httpx.get(f"{LLAMA}/props", timeout=30).json().get("build_info"))
    shown = httpx.post(f"{OLLAMA}/api/show", json={"model": MODEL}, timeout=30).json()
    print("ollama model parameters")
    print(shown.get("parameters", "(нет параметров)"), flush=True)


def main():
    describe()
    for mode, params in MODES.items():
        results = {}
        for engine, fn in (("ollama", ollama_run), ("llama", llama_run)):
            mean, sd, tokens = measure(fn, params)
            results[engine] = mean
            report(mode, engine, mean, sd, tokens)
        gap = (results["llama"] / results["ollama"] - 1) * 100
        print(f"{mode:20} llama относительно ollama {gap:+.1f}%", flush=True)


if __name__ == "__main__":
    main()
ollama 0.40.13
llama build b12033-785322d17
ollama model parameters
repeat_penalty                 1
stop                           "<|im_start|>"
stop                           "<|im_end|>"
temperature                    0.6
top_k                          20
top_p                          0.95
defaults             ollama     15.96 +-  0.66 tok/s  tokens=[96]
defaults             llama      16.19 +-  0.93 tok/s  tokens=[96]
defaults             llama относительно ollama +1.4%
aligned              ollama     14.27 +-  0.92 tok/s  tokens=[96]
aligned              llama      15.21 +-  2.15 tok/s  tokens=[96]
aligned              llama относительно ollama +6.6%
greedy               ollama     20.47 +-  0.27 tok/s  tokens=[96]
greedy               llama      19.06 +-  0.61 tok/s  tokens=[96]
greedy               llama относительно ollama -6.9%
Прогон показал следующее. Во всех трёх режимах оба сервера выдали ровно 96 токенов, так что длина текста и скорость здесь не смешиваются. В defaults llama-server оказался быстрее на 1.4% (16.19 против 15.96 токенов в секунду), и это меньше стандартных отклонений 0.66 и 0.93, то есть лежит внутри шума. В режиме aligned разрыв составил +6.6% (15.21 против 14.27), но разброс у llama-server там 2.15, у Ollama 0.92, и разница снова не выходит за него. В режиме greedy знак сменился, llama-server оказался медленнее на 6.9% (19.06 против 20.47) при отклонениях 0.61 и 0.27. Здесь разница крупнее разброса, но она противоположна по знаку результату aligned. Выравнивание не свело разрыв к нулю по определённому правилу, он просто меняет величину и знак от режима к режиму. Три прогона на CPU не дают оснований объявить какой-то движок быстрее. Честный итог в том, что на этой малой модели мы не нашли устойчивой разницы, а причину отрицательного разрыва в greedy не выяснили. Это не противоречит исходнику, который мерил GPU и 35-миллиардную модель.
Прогон ничего не говорит о спекулятивном декодировании на этом стенде. В основном замере мы его не включаем, и параметры драфтинга здесь не проверяются. Поведение на другой машине, GPU и других длинах контекста этот прогон тоже не доказывает.
Задания
Задания используют тот же стенд и тот же bench.py как библиотеку. Решения лежат рядом с ним.
Задание 1. Проверьте, меняет ли параметр draft_num_predict скорость Ollama на qwen3:0.6b. Сравните значения 0 и 2 в режиме greedy и объясните результат по числам прогона.
▶ Решение (нажмите, чтобы открыть)
# task1_draft.py · httpx 0.28.1 · Ollama 0.40.13
import bench


def main():
    for label, extra in (
        ("draft_num_predict 0", {"draft_num_predict": 0}),
        ("draft_num_predict 2", {"draft_num_predict": 2}),
    ):
        mean, sd, tokens = bench.measure(bench.ollama_run, bench.GREEDY, extra=extra)
        bench.report(label, "ollama", mean, sd, tokens)


if __name__ == "__main__":
    main()
draft_num_predict 0  ollama     19.22 +-  1.35 tok/s  tokens=[96]
draft_num_predict 2  ollama     17.88 +-  2.73 tok/s  tokens=[96]
Средние различаются примерно на 7% (19.22 против 17.88), но отклонения 1.35 и 2.73 такую разницу перекрывают, а число токенов одинаковое, 96. Устойчивого эффекта параметр на этой модели не показал, и ускорения от драфтинга нет. Вероятная причина в том, что у qwen3:0.6b нет встроенных MTP-слоёв и драфтинг не включается, но это предположение, прогон его не доказывает.
Задание 2. Выясните, влияет ли presence_penalty 1.5 на скорость у обоих серверов. Прогоните значения 0.0 и 1.5 при остальных одинаковых параметрах.
▶ Решение (нажмите, чтобы открыть)
# task2_presence.py · httpx 0.28.1 · Ollama 0.40.13 · llama.cpp server b12033
import bench


def main():
    for penalty in (0.0, 1.5):
        params = {**bench.GREEDY, "presence_penalty": penalty}
        for engine, fn in (("ollama", bench.ollama_run), ("llama", bench.llama_run)):
            mean, sd, tokens = bench.measure(fn, params)
            bench.report(f"presence_penalty {penalty}", engine, mean, sd, tokens)


if __name__ == "__main__":
    main()
presence_penalty 0.0 ollama     21.23 +-  0.23 tok/s  tokens=[96]
presence_penalty 0.0 llama      20.38 +-  0.89 tok/s  tokens=[96]
presence_penalty 1.5 ollama     16.84 +-  0.45 tok/s  tokens=[96]
presence_penalty 1.5 llama      18.36 +-  0.35 tok/s  tokens=[96]
Здесь эффект заметен на обоих серверах. У Ollama скорость упала с 21.23 до 16.84, примерно на 21%, у llama-server с 20.38 до 18.36, примерно на 10%. Стандартные отклонения 0.23, 0.89, 0.45 и 0.35 заметно меньше этих падений. Для сравнения, скорость Ollama в greedy при presence_penalty 0.0 отличается между двумя запусками (20.47 и 21.23) всего на 4%. Картина не совпадает с исходником, где замедлилась только сторона llama.cpp и причём на GPU. Причину мы не исследовали, а три прогона на одной машине не позволяют обобщать вывод на другие модели и оборудование.
Задание 3. Повторите замер на другой модели, например deepseek-r1:1.5b или qwen3:1.7b, и сравните картину с полученной на qwen3:0.6b.
▶ Решение (нажмите, чтобы открыть)
Менять нужно только переменные окружения. Скрипт запуска скачает новую модель, создаст ссылку на её GGUF под новым именем и пересоздаст контейнер llama-server. Затем bench.py запустится с той же моделью, потому что MODEL_TAG экспортируется.
# запуск run.sh с другой моделью · Ollama 0.40.13
MODEL_TAG=deepseek-r1:1.5b GGUF_NAME=deepseek-r1-1.5b.gguf ./run.sh
Сравнивайте не абсолютные скорости, а ту же схему. Смотрите, одинаково ли число токенов у серверов и выходит ли разрыв в defaults за пределы стандартного отклонения. Методику можно повторить, если модель умещается в лимит памяти 2 ГБ у llama-server. Если нет, увеличьте mem_limit с учётом общего бюджета.
Методику выравнивания настроек и воспроизводимого замера удобно переносить в рабочие процессы, где важно сравнивать модели и сервисы без самообмана. Подробнее об этом в курсе MLOps, разработка и внедрение ML-решений.