Калькулятор вроде GGUF VRAM calculator отвечает на вопрос, поместится ли квантованная модель в память и сколько останется под контекст. Мы взяли за основу заметку с dev.to про «три числа», но не пересказываем её, а пишем свой калькулятор. Он читает метаданные модели из Ollama и сверяет расчёт с тем, сколько памяти процесс показывает на самом деле. Проверка идёт на CPU, на малых моделях Qwen3, поэтому любой читатель повторит её на обычном ноутбуке.
Разбор исходника и три числа
Автор оригинала, разработчик под ником Mr Say Nothing, опубликовал на dev.to заметку GGUF VRAM calculator, the three numbers that decide. Её тезис в том, что вопрос «влезет ли квант» не вопрос ощущений, а сумма трёх слагаемых. Это веса, KV-кэш (key-value cache, кэш ключей и значений механизма внимания) и накладные расходы. Автор оформил расчёт как статическую страницу, которую можно открыть с диска, и сверил его с четырьмя публичными GGUF-файлами.
Для весов автор берёт число параметров, умножает на bpw (bits per weight, число бит на один вес), делит на восемь и домножает на 1.08. Восемь процентов нужны потому, что эмбеддинги и выходная голова в реальных файлах занимают больше, чем номинальный bpw кванта. Для KV-кэша формула перемножает два тензора (ключи и значения), число слоёв, число KV-голов, head_dim, два байта на элемент fp16 и длину контекста. Накладные расходы на CUDA-контекст, cuBLAS и буферы вычислений автор оценивает в 0.6-1.2 ГиБ.
Проверка в заметке такая. На Llama-2 7B, Llama-3 8B, Mistral 7B в Q4_K_M и Llama-3 8B в Q8_0 расчёт веса расходится с размером файла не больше чем на 0.04 ГБ. Отдельно автор признаёт собственную ошибку единиц. Размеры файлов в репозиториях указаны в десятичных ГБ, а монитор карты считает ГиБ, и 4.92 ГБ это уже 4.58 ГиБ, то есть треть восьмигигабайтной карты. Для Llama-3 8B (32 слоя, 8 KV-голов, head_dim 128) кэш занимает 128 КиБ на токен, то есть 1 ГиБ на 8k, 2 ГиБ на 16k и 4 ГиБ на 32k токенов. У Llama-2 7B полноценное multi-head внимание с 32 KV-головами, поэтому токен стоит вчетверо дороже, 512 КиБ. В text-generation-webui те же три числа прячутся за параметрами n_ctx, n-gpu-layers и cache_type, а переход кэша с fp16 на q8_0 по словам автора вдвое сокращает строку кэша.
Своего у нас в этой статье три вещи. Первая это замена оценки весов на реальный размер файла из Ollama. Вторая это чтение слоёв и KV-голов из метаданных вместо ручной подстановки. Третья это сверка расчёта с фактом на малых Qwen3, потому что заметка проверяла только вес файла и не измеряла итоговую память процесса. Наш стенд работает только на CPU и CUDA-буферов не имеет, поэтому поправку 1.08 в основном расчёте мы не используем. Остаток между расчётом и фактом разберём по выводу прогона.
Откуда берутся числа, метаданные GGUF и размер файла
GGUF описывает себя сам. По спецификации формата в ggml это единый файл, в котором лежит всё необходимое для загрузки, а гиперпараметры хранятся как пары ключа и значения, а не как список безымянных чисел. Ключи иерархические, и для архитектуры, например qwen3, они выглядят как префикс архитектуры плюс имя поля. Нас интересуют block_count (число слоёв), embedding_length, attention.head_count, attention.head_count_kv и context_length. Если в файле есть attention.key_length, то это и есть head_dim. Иначе его придётся оценить как embedding_length, делённый на число голов внимания.
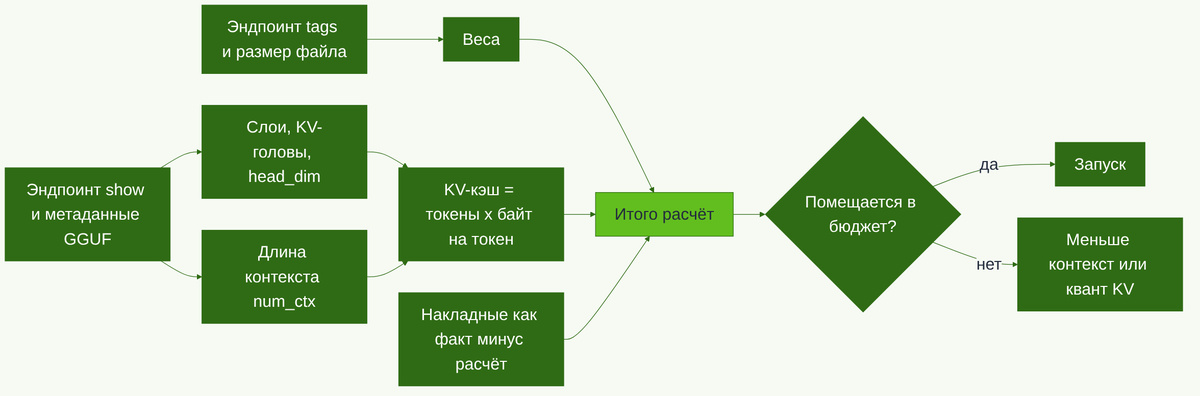
Вес модели в калькуляторе считается просто. Файл GGUF и есть квантованные веса вместе с тем, что не поддалось квантованию, поэтому делить параметры на восемь и умножать на 1.08 нам не нужно. Достаточно размера файла. Число параметров из метаданных пригодится в другом, а именно чтобы вычислить фактический bpw файла.
Ollama отдаёт все эти поля через HTTP. Эндпоинт show из документации API возвращает блок model_info с метаданными, а эндпоинт со списком локальных моделей даёт размер файла в байтах. Имена ключей код строит по общему шаблону, то есть префикс архитектуры из general.architecture плюс имя поля.
KV-кэш и почему счёт растёт при том же файле
Файл не меняется, а счёт растёт, потому что KV-кэш пропорционален длине контекста. Для Llama-3 8B из исходника вычисление 2 × 32 × 8 × 128 × 2 даёт 131 072 байта на токен, то есть 128 КиБ. На 8k токенов это 1 ГиБ, на 32k уже 4 ГиБ. Современные модели с групповым вниманием (grouped-query attention, GQA) делят KV-головы между группами запросов и потому дешевле на длинном контексте. Если вам интересно, как это устроено внутри трансформера, начните с курса Нейронные сети на Python.
У KV-кэша есть и вторая рукоятка, его тип. По устройству блоков квантования в ggml размер элемента при переходе с fp16 на q8_0 падает с 2 байт до 34/32, то есть примерно в 1.9 раза, а это согласуется с «вдвое» из исходника. Это арифметика по формату блоков, а не замер на стенде, и о качестве мы здесь ничего не утверждаем. Проверим расчёт в первом задании.
Где формула слепа и чем её заменить
Автор исходника сам называет три слепых зоны. Первая это MoE-модели (mixture of experts, смесь экспертов), в которых маршрутизация по экспертам не видна расчёту по слоям. Вторая это черновые модели спекулятивного декодирования, которые занимают ту же память. Третья это доля рабочего стола, то есть память, которую занимают ваши вкладки и приложения. Заявленная точность 0.04 ГБ, по его же словам, держится только для плотных моделей.
В MoE-модели на токен активна лишь часть параметров, но в память помещаются все эксперты. Поэтому активные параметры не уменьшают требований к весам, они ускоряют генерацию. Крупные MoE-модели не поместятся на нашем стенде, поэтому в прогоне работают малые Qwen3, а MoE мы разберём арифметикой в третьем задании. Частичный offload на GPU (когда часть слоёв живёт в видеопамяти, часть в оперативной) на нашем стенде не возникает вовсе. Пользователям с видеокартой после наших расчётов придётся прибавить собственные буферы.
Прежде чем писать код, сравним четыре способа ответить на вопрос «поместится ли».
| Способ | Нужен ли файл модели | Учёт длины контекста | Учёт числа KV-голов | Учёт MoE |
|---|---|---|---|---|
| Правило «размер файла плюс 20%» | Нужен только размер | Нет | Нет | Нет |
| Формула из исходника | Нет, хватает числа параметров и bpw | Да | Да, если подставить вручную | Нет, автор называет это слепой зоной |
| Наш калькулятор по метаданным | Модель должна быть загружена в Ollama | Да | Да, поле читается из метаданных | Веса учтены размером файла, динамика экспертов не моделируется |
| Запуск и просмотр факта | Нужен | Только для заданного num_ctx | Включено в факт | Включено в факт |
Разбор получается такой. Правило с запасом хорошо для прикидки на салфетке, но оно слепо к контексту, а именно контекст ломает «вчера влезало». Формула исходника выигрывает, когда файла нет под рукой и надо решить, стоит ли его скачивать. Наш калькулятор нужен, когда модель уже в Ollama и важно подобрать num_ctx и тип кэша до запуска. Прямой запуск всегда точнее, но стоит минут на каждую проверку и не подскажет, что будет при другом контексте. Поэтому расчёт и факт стоит сводить в одну таблицу, чем мы и займёмся.
Практика, калькулятор на Python и сверка с Ollama на Qwen3
Стенд состоит из одного сервиса. Контейнер Ollama из кэша стенда ограничен четырьмя гигабайтами, порт опубликован только на локальном интерфейсе. Скрипты запускаются из виртуального окружения на хосте и ходят в Ollama по HTTP, поэтому отдельный контейнер с Python не нужен. Всё вместе укладывается в лимит 6 ГБ.
# compose.yaml · Ollama 0.40.13
services:
  ollama:
    image: ollama/ollama:0.40.13
    mem_limit: 4g
    ports:
      - "127.0.0.1:11434:11434"
# requirements.txt
requests==2.32.3
Скрипт запуска поднимает стенд, дожидается ответа Ollama, скачивает две модели Qwen3 и запускает основной пример. Он не гасит стенд, это делает раннер.
#!/usr/bin/env bash
# run.sh · Ollama 0.40.13 · requests 2.32.3
set -euo pipefail

docker compose up -d
until docker compose exec -T ollama ollama list >/dev/null 2>&1; do
  sleep 2
done
docker compose exec -T ollama ollama pull qwen3:0.6b
docker compose exec -T ollama ollama pull qwen3:1.7b

python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python calc.py
Теперь сам калькулятор в одном файле calc.py. Функция specs собирает слои, KV-головы и head_dim из model_info, а при отсутствии attention.key_length оценивает head_dim по числу голов. Размер файла берётся из списка локальных моделей. Функция measure запускает генерацию с заданным num_ctx, читает поле size загруженной модели из списка запущенных (эндпоинт /api/ps) и выгружает её. Это поле мы используем как факт занятой памяти, другого источника на стенде нет. Функция main печатает расчёт для трёх контекстов и сверку с фактом для двух.
# calc.py · requests 2.32.3 · Ollama 0.40.13
import time

import requests

BASE = "http://127.0.0.1:11434"
GIB = 1024 ** 3
CONTEXTS_CALC = [2048, 8192, 32768]
CONTEXTS_RUN = [2048, 8192]
MODELS = ["qwen3:0.6b", "qwen3:1.7b"]


def show(model):
    r = requests.post(f"{BASE}/api/show", json={"model": model}, timeout=60)
    r.raise_for_status()
    return r.json()["model_info"]


def file_size(model):
    r = requests.get(f"{BASE}/api/tags", timeout=60)
    r.raise_for_status()
    for m in r.json()["models"]:
        if m["name"] == model:
            return m["size"]
    raise KeyError(model)


def specs(model):
    mi = show(model)
    arch = mi["general.architecture"]
    heads = mi[f"{arch}.attention.head_count"]
    emb = mi[f"{arch}.embedding_length"]
    return {
        "layers": mi[f"{arch}.block_count"],
        "heads": heads,
        "kv_heads": mi.get(f"{arch}.attention.head_count_kv", heads),
        "head_dim": mi.get(f"{arch}.attention.key_length", emb // heads),
        "max_ctx": mi[f"{arch}.context_length"],
        "params": mi.get("general.parameter_count"),
        "weights": file_size(model),
    }


def kv_bytes_per_token(s, bytes_per_elem=2.0):
    return 2 * s["layers"] * s["kv_heads"] * s["head_dim"] * bytes_per_elem


def _loaded():
    r = requests.get(f"{BASE}/api/ps", timeout=60)
    r.raise_for_status()
    return r.json().get("models", [])


def unload(model):
    requests.post(f"{BASE}/api/generate",
                  json={"model": model, "keep_alive": 0, "stream": False},
                  timeout=120)
    for _ in range(30):
        if not any(m.get("name") == model or m.get("model") == model
                   for m in _loaded()):
            return
        time.sleep(1)


def measure(model, num_ctx):
    """Загружает модель с num_ctx и возвращает занятую память (байт) из /api/ps."""
    unload(model)
    r = requests.post(
        f"{BASE}/api/generate",
        json={"model": model, "prompt": "hi", "stream": False,
              "keep_alive": "5m",
              "options": {"num_ctx": num_ctx, "num_predict": 1}},
        timeout=600,
    )
    r.raise_for_status()
    size = None
    for m in _loaded():
        if m.get("name") == model or m.get("model") == model:
            size = m["size"]
    unload(model)
    if size is None:
        raise RuntimeError(f"{model} не найдена в /api/ps")
    return size


def main():
    for model in MODELS:
        s = specs(model)
        per = kv_bytes_per_token(s)
        if s["params"]:
            bpw = s["weights"] * 8 / s["params"]
        else:
            bpw = float("nan")
        print(f"== {model} ==")
        print(f"слои {s['layers']}, KV-головы {s['kv_heads']} из {s['heads']}, "
              f"head_dim {s['head_dim']}, контекст модели {s['max_ctx']}")
        print(f"файл {s['weights'] / GIB:.2f} ГиБ, фактический bpw {bpw:.2f}, "
              f"KV {per / 1024:.0f} КиБ на токен")
        for ctx in CONTEXTS_CALC:
            kv = per * ctx
            total = s["weights"] + kv
            print(f"расчёт num_ctx={ctx}  KV {kv / GIB:.2f} ГиБ  "
                  f"итого {total / GIB:.2f} ГиБ")
        for ctx in CONTEXTS_RUN:
            kv = per * ctx
            calc_total = s["weights"] + kv
            fact = measure(model, ctx)
            diff = (fact - calc_total) / fact * 100
            rest = fact - calc_total
            print(f"сверка num_ctx={ctx}  расчёт {calc_total / GIB:.2f} ГиБ  "
                  f"факт {fact / GIB:.2f} ГиБ  расхождение {diff:+.1f}%  "
                  f"остаток {rest / GIB:.2f} ГиБ")


if __name__ == "__main__":
    main()
== qwen3:0.6b ==
слои 28, KV-головы 8 из 16, head_dim 128, контекст модели 40960
файл 0.49 ГиБ, фактический bpw 5.56, KV 112 КиБ на токен
расчёт num_ctx=2048  KV 0.22 ГиБ  итого 0.71 ГиБ
расчёт num_ctx=8192  KV 0.88 ГиБ  итого 1.36 ГиБ
расчёт num_ctx=32768  KV 3.50 ГиБ  итого 3.99 ГиБ
сверка num_ctx=2048  расчёт 0.71 ГиБ  факт 0.73 ГиБ  расхождение +3.3%  остаток 0.02 ГиБ
сверка num_ctx=8192  расчёт 1.36 ГиБ  факт 1.43 ГиБ  расхождение +4.6%  остаток 0.07 ГиБ
== qwen3:1.7b ==
слои 28, KV-головы 8 из 16, head_dim 128, контекст модели 40960
файл 1.27 ГиБ, фактический bpw 5.35, KV 112 КиБ на токен
расчёт num_ctx=2048  KV 0.22 ГиБ  итого 1.48 ГиБ
расчёт num_ctx=8192  KV 0.88 ГиБ  итого 2.14 ГиБ
расчёт num_ctx=32768  KV 3.50 ГиБ  итого 4.77 ГиБ
сверка num_ctx=2048  расчёт 1.48 ГиБ  факт 1.54 ГиБ  расхождение +3.4%  остаток 0.05 ГиБ
сверка num_ctx=8192  расчёт 2.14 ГиБ  факт 2.26 ГиБ  расхождение +5.3%  остаток 0.12 ГиБ
Как читать результат. Строки «расчёт» показывают то, что мы получаем без запуска, и именно они отвечают на вопрос «влезет ли». Строки «сверка» ставят рядом расчёт и факт, и расхождение составило от 3.3% до 5.3% в сторону факта. Столбец «остаток» это просто разность между полем size из /api/ps и нашей суммой файла и KV-кэша, и чем он на самом деле является, прогон не доказывает. Вероятно, в него входят буферы вычислений и служебные структуры Ollama, но туда же попадает и отклонение реальных размеров KV от нашей формулы. Это гипотеза. Зато по выводу видно, что остаток не постоянен и на двух проверенных точках вырос вместе с num_ctx. Для qwen3:0.6b он вырос с 0.02 до 0.07 ГиБ при переходе от 2048 к 8192 токенам, для qwen3:1.7b с 0.05 до 0.12 ГиБ. Что происходит между этими точками и за ними, прогон не показывает. Это важно для задания 2. Ещё одно наблюдение касается весов. Фактический bpw файлов получился 5.56 и 5.35, и малые модели несут в себе заметную долю эмбеддингов, поэтому размер файла надёжнее любой поправки к номинальному bpw. Если у вас GPU, то поправки на CUDA из исходника придётся добавить поверх.
Задания
Три задачи используют готовые функции из calc.py. Каждое решение лежит в отдельном файле рядом с ним и запускается тем же способом.
Задание 1. Добавьте квантованный KV-кэш и найдите, при каком максимальном контексте qwen3:1.7b укладывается в бюджет 2 ГиБ для типов f16, q8_0 и q4_0.
Решение
Размер элемента берём из устройства блоков квантования в ggml. Блок q8_0 хранит 32 значения в 34 байтах (2 байта масштаба и 32 байта данных), то есть 1.0625 байта на элемент, а блок q4_0 хранит 32 значения в 18 байтах, то есть 0.5625 байта на элемент. Эти размеры мы взяли из формата блоков и на стенде не проверяли, как и то, что Ollama использует именно такие блоки для KV-кэша. Накладные расходы здесь не учитываются, а запуска с квантованным кэшем нет вовсе, поэтому результат это теоретическая оценка верхней границы, а не замер.
# task1_kvquant.py · requests 2.32.3 · Ollama 0.40.13
from calc import GIB, specs, kv_bytes_per_token

MODEL = "qwen3:1.7b"
BUDGET = 2 * GIB
TYPES = {"f16": 2.0, "q8_0": 34 / 32, "q4_0": 18 / 32}

s = specs(MODEL)
free = BUDGET - s["weights"]
print(f"веса {s['weights'] / GIB:.2f} ГиБ, на KV остаётся {free / GIB:.2f} ГиБ")
for name, size in TYPES.items():
    per = kv_bytes_per_token(s, size)
    ctx = int(free // per) if free > 0 else 0
    ctx = min(ctx, s["max_ctx"])
    print(f"{name}  {per / 1024:.1f} КиБ на токен  максимальный контекст {ctx}")
веса 1.27 ГиБ, на KV остаётся 0.73 ГиБ
f16  112.0 КиБ на токен  максимальный контекст 6872
q8_0  59.5 КиБ на токен  максимальный контекст 12936
q4_0  31.5 КиБ на токен  максимальный контекст 24435
Задание 2. Напишите подбор максимального num_ctx по бюджету памяти и проверьте его запуском. Возьмите qwen3:0.6b и бюджет 1.5 ГиБ.
Решение
Это намеренно наивная первая версия. Сначала делаем пробный запуск на 2048 токенов и вычисляем остаток как разность размера из списка запущенных моделей и суммы файла и KV-кэша. Затем делим свободное место на стоимость токена, округляем вниз до кратного 256 и запускаем модель уже с найденным контекстом. Остаток при этом переносится с пробного запуска на целевой без изменений, хотя в основном выводе выше он на двух точках вырос вместе с num_ctx. Прогон покажет, чего стоит такое упрощение.
# task2_fit_ctx.py · requests 2.32.3 · Ollama 0.40.13
from calc import GIB, specs, kv_bytes_per_token, measure

MODEL = "qwen3:0.6b"
BUDGET = 1.5 * GIB
PROBE_CTX = 2048

s = specs(MODEL)
per = kv_bytes_per_token(s)
probe = measure(MODEL, PROBE_CTX)
overhead = probe - s["weights"] - per * PROBE_CTX
print(f"пробный запуск {probe / GIB:.2f} ГиБ, накладные {overhead / GIB:.2f} ГиБ")

ctx = int((BUDGET - s["weights"] - overhead) // per)
ctx = min(ctx // 256 * 256, s["max_ctx"])
if ctx < 256:
    print("в бюджет не помещается даже минимальный контекст")
else:
    fact = measure(MODEL, ctx)
    verdict = "укладывается" if fact <= BUDGET else "превышает бюджет"
    print(f"подобран num_ctx={ctx}, факт {fact / GIB:.2f} ГиБ из "
          f"{BUDGET / GIB:.2f} ГиБ, {verdict}")
пробный запуск 0.73 ГиБ, накладные 0.02 ГиБ
подобран num_ctx=9216, факт 1.54 ГиБ из 1.50 ГиБ, превышает бюджет
Здесь не сработало. Проверим арифметику. KV-кэш при num_ctx=9216 равен 112 КиБ × 9216, то есть около 0.98 ГиБ. Метод заложил веса 0.49 ГиБ, этот кэш и остаток 0.02 ГиБ, в сумме около 1.49 ГиБ, то есть впритык под бюджет. Фактически получилось 1.54 ГиБ, и остаток 1.54 − 0.49 − 0.98 составил около 0.07 ГиБ. Недооценка остатка на 0.05 ГиБ и дала превышение бюджета на 0.04 ГиБ. Такой же остаток 0.07 ГиБ мы видели в основном выводе на 8192 токенах, поэтому надёжно прогон показывает только одно, что остаток вырос между 2048 и 8192 токенами. Как он ведёт себя дальше, при трёх и более точках, мы не проверяли, и возможно, это буферы вычислений. Метод стоит поправить. Можно заложить запас (скажем, 0.1 ГиБ) в расчёт контекста или после первой попытки замерить факт ещё раз и уменьшить num_ctx шагами по 256. Такую версию мы не запускали, поэтому не утверждаем, что она уложится в бюджет.
Задание 3. Оцените без запуска память под веса и KV-кэш для условной MoE-модели с 30.5 млрд общих параметров, 3.3 млрд активных, 48 слоями, 4 KV-головами и head_dim 128, и объясните, почему активные параметры её не уменьшают.
Решение
Эти параметры мы задаём сами для примера, это не данные конкретной опубликованной модели и не результат стендового прогона. Значения bpw для Q4_0 и Q8_0 (4.5 и 8.5 бита) следуют из размеров блоков ggml, то есть 18 байт на 32 значения и 34 байта на 32 значения. Поправку 1.08 из исходника показываем отдельной строкой. На реальных файлах мы её не проверяли, и для MoE-модели в Q4_0 неизвестно, насколько она применима, поэтому считайте её ориентиром сверху. Итог это теоретическая оценка, а не замер.
# task3_moe.py · условная MoE-модель · без запуска · python 3.13
GIB = 1024 ** 3
TOTAL = 30.5e9
ACTIVE = 3.3e9
LAYERS, KV_HEADS, HEAD_DIM = 48, 4, 128
BPW = {"F16": 16.0, "Q8_0": 8.5, "Q4_0": 4.5}
FACTOR = 1.08

for name, bpw in BPW.items():
    w = TOTAL * bpw / 8
    print(f"{name}  веса {w / GIB:.1f} ГиБ, с поправкой 1.08 {w * FACTOR / GIB:.1f} ГиБ")

per = 2 * LAYERS * KV_HEADS * HEAD_DIM * 2
print(f"KV fp16 {per / 1024:.0f} КиБ на токен")
for ctx in (2048, 8192, 32768):
    print(f"контекст {ctx}  KV {per * ctx / GIB:.2f} ГиБ")

active_q4 = ACTIVE * BPW["Q4_0"] / 8
print(f"если бы жили только активные параметры в Q4_0, было бы {active_q4 / GIB:.1f} ГиБ, "
      f"но маршрутизатор выбирает экспертов на каждом токене по-разному, "
      f"поэтому в памяти должны лежать все")
F16  веса 56.8 ГиБ, с поправкой 1.08 61.4 ГиБ
Q8_0  веса 30.2 ГиБ, с поправкой 1.08 32.6 ГиБ
Q4_0  веса 16.0 ГиБ, с поправкой 1.08 17.3 ГиБ
KV fp16 96 КиБ на токен
контекст 2048  KV 0.19 ГиБ
контекст 8192  KV 0.75 ГиБ
контекст 32768  KV 3.00 ГиБ
если бы жили только активные параметры в Q4_0, было бы 1.7 ГиБ, но маршрутизатор выбирает экспертов на каждом токене по-разному, поэтому в памяти должны лежать все
Причина в самой маршрутизации. Выбор экспертов зависит от токена, поэтому заранее неизвестно, какие из них понадобятся следующими, и держать нужно всех. Выигрыш MoE состоит в числе операций на токен, а не в объёме хранимых весов.
Если вы хотите довести эту арифметику до рабочей практики, то есть упаковать расчёт в сервис, добавить мониторинг памяти и выкатывать локальные модели в продакшен, это тема курса MLOps, разработка и внедрение ML-решений.