Hybrid Search RAG на локальных моделях решает задачу, на которой обычный векторный поиск по новостям спотыкается о слово «золото» и может принести вместо цен на металл репортаж о медалисте. Пост на Хабре описывает self-hosted систему на PostgreSQL, Ollama и LangGraph, где эту проблему лечат объединением векторного и лексического поиска. В статье мы разберём механизм по документации, соберём на CPU воспроизводимый стенд с маленьким корпусом омонимов, измерим Recall@3 для трёх режимов поиска и подключим к нему LangGraph-агента на qwen3:1.7b.
О чём статья на Хабре и что в ней главное
Пост «Как построить self-hosted RAG-систему с LangGraph-агентом на локальных LLM» (оригинал на Хабре) написал разработчик под ником Knez. Он собрал систему вопросов и ответов по новостным лентам, которая работает без облачных API. Мотив прямой. Автору нужны полная автономность и независимость от внешних провайдеров, в том числе устойчивость к санкциям. Стек автора включает Python, FastAPI, PostgreSQL с pgvector, Celery, LangGraph, Ollama с моделями Qwen 2.5 14B и BGE-M3, Streamlit, Langfuse и Docker.
Корпус в посте большой, более 12 тысяч статей из RSS-лент. Сначала автор искал только по косинусному расстоянию между эмбеддингами. Простые запросы работали, а на запросах вроде «ключевая ставка ЦБ» вектор выдавал мусор. Самым наглядным оказался запрос «золото», по которому находились статьи о фигуристе, взявшем золото на соревнованиях, а не о ценах на металл. Лечение состояло в слиянии векторной ветки с лексической на tsvector через RRF (Reciprocal Rank Fusion). По сообщению автора, Recall@5 после этого вырос с 0.2 до 0.53.
Из остального в посте для нас важны следующие идеи.
- Классификация LLM. Сначала модель отправила 74 процента статей в категорию other, потому что промпт разрешал выбирать её при сомнении. После переписывания промпта с чёткими описаниями категорий доля other упала до 0.03 процента, а ручная проверка выборки показала точность около 85 процентов.
- Агент с тремя инструментами. Это гибридный поиск, SQL-агрегации и поиск по компаниям и тональности. Какой из них вызвать, решает модель на графе LangGraph.
- Наблюдаемость. Автор развернул Langfuse и видит каждый шаг агента, расход токенов и аргументы, которые модель передала инструментам.
- Грабли локального стека. Ollama выгружала модели при переключении, и запрос занимал около минуты, а значение OLLAMA_MAX_LOADED_MODELS=2 это исправило. Обёртка ChatOllama из LangChain, по словам автора, давала девятикратное замедление, и он перешёл на прямой клиент. Рост OLLAMA_NUM_PARALLEL с 1 до 2 ускорил классификацию минимум в полтора раза.
Цифры автора относятся к его корпусу и его железу, а наш стенд намного меньше, поэтому напрямую сравнивать числа нельзя. Дальше мы разбираем сам механизм и проверяем его на своих данных.
Почему векторный поиск ошибается на омонимах
Модель эмбеддингов (embedding model) превращает текст в вектор, и близость векторов отражает близость тем, а не совпадение слов. Запрос из одного слова почти не несёт контекста. Слово «золото» живёт в нескольких темах сразу, это рынок металлов, спорт и ювелирное дело, поэтому среди ближайших соседей запроса легко оказываются документы из разных значений. То же происходит со словом «ставка», которая бывает ключевой ставкой ЦБ, ставкой в покере и ставкой клуба на молодёжь.
Обратная проблема есть у лексического поиска. Он точно находит документы со словом «ОПЕК», но не знает, что «регулятор повысил проценты» и «ЦБ изменил ставку» говорят об одном. Поэтому ни одна из двух веток не годится как единственная, и на этом построен гибридный подход.
Есть и техническая оговорка. По документации pgvector, без индекса поиск точный и даёт полный recall, а приближённый индекс (HNSW или IVFFlat) обменивает часть recall на скорость. На корпусе из тридцати строк планировщик Postgres всё равно может читать таблицу целиком, так что индекс в нашем замере скорее для демонстрации DDL, чем для влияния на результат.
Как работает Hybrid Search на tsvector, pgvector и RRF
Гибридный поиск запускает две независимые ветки по одному запросу и сливает два ранжированных списка в один. Ветки живут в одной таблице Postgres, отдельная поисковая система не нужна. Сам README pgvector в разделе Hybrid Search советует использовать расширение вместе с полнотекстовым поиском Postgres и объединять результаты через Reciprocal Rank Fusion или cross-encoder.
Лексическая ветка на tsvector
Функция to_tsvector разбирает документ на токены и приводит их к лексемам по выбранной конфигурации словаря, а предопределённые конфигурации есть для разных языков. Для русских новостей мы берём конфигурацию russian. Запрос превращает в tsquery функция to_tsquery, причём стоп-слова она отбрасывает. Ранжируют ts_rank и ts_rank_cd, а второй дополнительно учитывает близость совпавших слов друг к другу.
Здесь есть неточность, которую стоит проговорить. Автор поста называет лексическую ветку BM25, но встроенные функции ранжирования Postgres считают частоту лексем, близость и вес части документа, а глобальную статистику по корпусу не используют. Документация прямо говорит, что это примеры, а не готовое решение. Для нашей задачи этого достаточно, потому что мы берём из лексической ветки порядок документов, а не абсолютные оценки.
Векторная ветка на pgvector
Косинусное расстояние в pgvector задаётся оператором <=>, а индекс HNSW строится с классом операторов vector_cosine_ops. По умолчанию параметры m=16 и ef_construction=64, глубина поиска hnsw.ef_search равна 40. Индекс используется только тогда, когда запрос содержит ORDER BY по оператору расстояния и LIMIT. Если обернуть расстояние в выражение вроде 1 — (embedding <=> …), планировщик индекс не возьмёт, и это одна из самых частых причин «индекс не работает».
Слияние через RRF
RRF не смотрит на сырые оценки веток, потому что косинусное расстояние и ts_rank_cd живут в несовместимых шкалах. Он берёт только позиции. Документ, стоящий на месте rank в списке, получает 1/(k + rank), а оценки из разных списков суммируются. Параметр k сглаживает разрыв между первыми местами, и в практике часто встречается значение 60. Документ, который оказался высоко в обоих списках, выигрывает у документа, который лидирует только в одном.
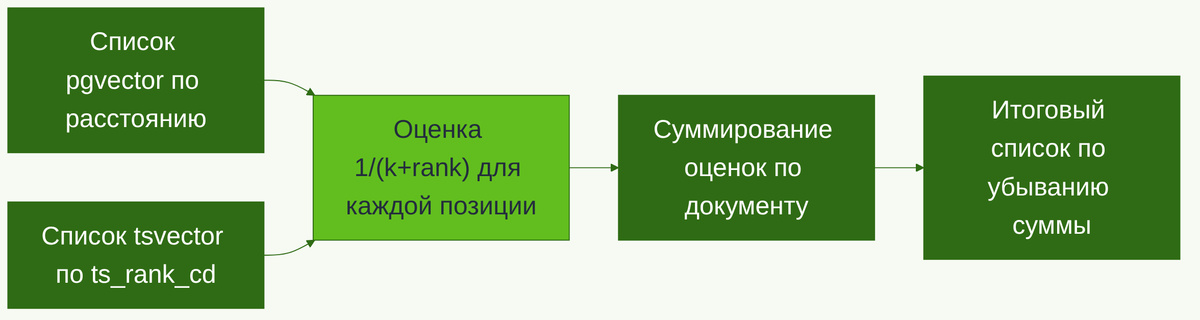
Сводка режимов поиска показывает, чем платим за каждый из них.
| Режим | Синонимы и перефразировки | Точные термины и омонимы | Что нужно в инфраструктуре |
|---|---|---|---|
| Только вектор (pgvector) | Находит по смыслу | Слабое место, омонимы смешиваются | Расширение pgvector, модель эмбеддингов |
| Только лексика (tsvector) | Не находит, если слова разные | Находит по лексеме, но значение слова не различает | Встроенный полнотекстовый поиск Postgres |
| Гибрид через RRF | Берёт в итоговый список документы векторной ветки | Берёт в итоговый список документы лексической ветки, но омонимию «золота» на нашем корпусе не снял | То же, что у двух предыдущих, одна база |
Гибрид должен помогать там, где ветки ошибаются по-разному. На запросе «золото» в нашем прогоне топ-3 лексической ветки состоял из документов 1, 2 и 3, топ-3 векторной из документов 5, 1 и 4, и общим оказался только документ 1. Он стал первым в итоге RRF, а следом встали документ 5 из векторной ветки и документ 2 из лексической. Это иллюстрация механизма, а не доказательство выигрыша на омонимах. Если запрос сформулирован словами, которых в документе нет, лексическая ветка промолчит, а вектор может вытянуть результат. Платой становится второй проход по данным и лишний шаг слияния, а сам выигрыш мы проверим на своём корпусе, а не примем на веру.
LangGraph-агент с инструментами, когда нужен граф, а не цепочка
Линейный RAG делает одно и то же на любой вопрос. Он ищет, подставляет найденное в промпт и отвечает. Вопрос «Сколько новостей про энергетику за три дня» к такой схеме не подходит, потому что ответ нужно посчитать SQL-агрегацией, а не прочитать из текстов. Граф состояний (state graph) в LangGraph добавляет ветвление. Узел-планировщик (planner) смотрит на вопрос, решает, нужен ли инструмент и какой именно, и маршрутизатор отправляет выполнение дальше по условному ребру.
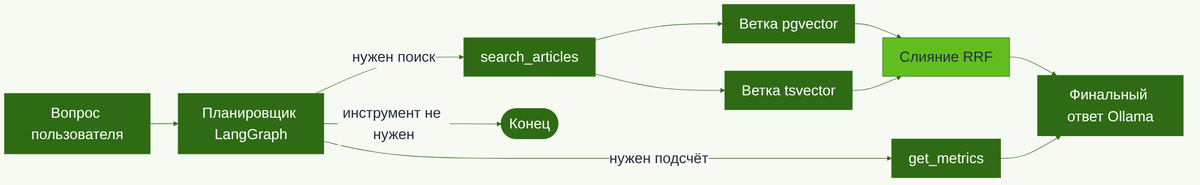
Наш граф устроен просто. Планировщик получает вопрос и описание двух инструментов, search_articles и get_metrics. Если модель вернула вызов, управление идёт в узел tools, затем в узел finalizer, который формулирует ответ без доступа к инструментам. Если вызова нет, граф завершается сразу. Третий инструмент, search_by_entity, мы добавим в задании.
Надёжность такого агента упирается в способность модели правильно выбрать инструмент, а на малой модели это самое слабое звено. Поэтому в практике мы печатаем трассу вызовов, а не только текст ответа. Автор поста для этого использует Langfuse, а у нас трассу заменяет строка «Вызовы» в выводе. Как строить агентов с инструментами и оценивать их поведение, подробно разбирается в курсе AI-агенты для оптимизации бизнес-процессов.
Ограничения локального стека, Ollama, параллелизм, выгрузка моделей
Локальный запуск экономит на API, но переносит заботы о ресурсах на вас. Из конфигурации нашего стенда и из опыта автора поста вытекает несколько ограничений.
- Выгрузка моделей. RAG использует минимум две модели, эмбеддинги и генерацию. Если Ollama держит в памяти только одну, при переключении ей приходится загружать веса заново, и автор поста ловил на этом минутные запросы. Он решил проблему значением OLLAMA_MAX_LOADED_MODELS=2. На нашем стенде в compose.yaml стоит значение 1, потому что память ограничена, и влияние этого выбора на время работы мы не измеряли.
- Параллелизм. Переменная OLLAMA_NUM_PARALLEL у нас равна 1, потому что на стенде четыре гигабайта под Ollama и только CPU. Автор поста сообщает об ускорении минимум в полтора раза при значении 2 на своём железе, а у нас выигрыш от большего значения не измерялся.
- Обёртки над клиентом. Любая обёртка вроде ChatOllama из LangChain добавляет слой между вашим кодом и сервером. Автор поста связал ChatOllama с девятикратным замедлением и ушёл на прямой клиент. Мы этот слой не измеряли, но в практике тоже берём прямой клиент ollama.
- Размер моделей. Модель уровня Qwen 2.5 14B, которую использует автор, в наши четыре гигабайта не уместилась бы. Мы берём qwen3:1.7b и эмбеддинг-модель qwen3-embedding:0.6b как наименьшие по памяти.
Способ вызова модели тоже влияет на число зависимостей и на то, сколько кода стоит между вами и сервером.
| Способ | Зависимости | Накладные расходы |
|---|---|---|
| LangChain ChatOllama | LangChain и интеграция с Ollama | Дополнительный слой, автор поста сообщает о девятикратном замедлении в своём пайплайне |
| Прямой клиент ollama (Client, AsyncClient) | Один пакет ollama | Минимум кода между приложением и HTTP API Ollama |
| OpenAI-совместимый API | Любой клиент OpenAI | Тот же сервер, путь /v1 на порту 11434 по документации Ollama |
В практике мы берём прямой клиент. Имена моделей и адрес Ollama читаются из переменных окружения, а получение эмбеддингов и вызовы чата собраны в common.py и agent.py. Поместятся ли другие модели вместе с чат-моделью в наши четыре гигабайта Ollama, мы не проверяли.
Практика, гибридный поиск на pgvector и агент на Qwen3 1.7B
Стенд состоит из двух контейнеров. В кэше стенда лежит чистый postgres:16.4 без расширения pgvector, поэтому берём образ pgvector/pgvector с тегом 0.8.0-pg16. Это релиз линейки 0.8, в которой появились итеративные сканы индекса, а актуальный патч-релиз репозитория новее, но для нашего примера отличий нет. Ollama ограничена четырьмя гигабайтами, Postgres одним, всего пять гигабайт, порты открыты только на 127.0.0.1. Сначала файл compose.yaml.
# compose.yaml · pgvector 0.8.0 · PostgreSQL 16 · Ollama 0.40.13
services:
  db:
    image: pgvector/pgvector:0.8.0-pg16
    mem_limit: 1g
    environment:
      POSTGRES_USER: rag
      POSTGRES_PASSWORD: rag
      POSTGRES_DB: rag
    ports:
      - "127.0.0.1:5432:5432"
  ollama:
    image: ollama/ollama:0.40.13
    mem_limit: 4g
    environment:
      OLLAMA_MAX_LOADED_MODELS: "1"
      OLLAMA_NUM_PARALLEL: "1"
    ports:
      - "127.0.0.1:11434:11434"
Зависимости зафиксированы точными версиями. Пакет psycopg отвечает за доступ к Postgres, ollama это официальный клиент, langgraph даёт граф состояний. Версия langgraph 0.2.60 выбрана потому, что на ней проверен код графа из статьи. Прогон выполнялся в окружении с Python 3.12, а образ python 3.13 в стенде не использовался, так как все сервисы работают в контейнерах. При запуске библиотека печатает предупреждение LangChainPendingDeprecationWarning про параметр allowed_objects, на результат поиска и агента оно не влияет.
# requirements.txt
psycopg[binary]==3.2.3
ollama==0.6.0
langgraph==0.2.60
Скрипт run.sh поднимает стенд, ждёт готовности Postgres и Ollama, скачивает три модели (третья нужна для задания), ставит зависимости в .venv и запускает основной пример.
#!/usr/bin/env bash
# run.sh · Docker Compose · Python 3
set -euo pipefail
cd "$(dirname "$0")"
docker compose up -d
until docker compose exec -T db pg_isready -U rag -d rag >/dev/null 2>&1; do sleep 2; done
until curl -sf http://127.0.0.1:11434/api/tags >/dev/null; do sleep 2; done
for model in qwen3-embedding:0.6b qwen3:1.7b deepseek-r1:1.5b; do
  docker compose exec -T ollama ollama pull "$model"
done
python3 -m venv .venv
.venv/bin/pip install --quiet -r requirements.txt
.venv/bin/python hybrid_eval.py
Общий модуль common.py содержит корпус из 30 коротких новостей с омонимами, 12 размеченных запросов, обе ветки поиска, RRF и два инструмента для агента. Таблица создаётся при первом обращении к базе, а повторные запуски используют готовые данные. Лексический запрос собирается из слов через OR, иначе длинный запрос потребовал бы совпадения всех слов сразу. Recall@3 считается как доля найденных релевантных документов, при этом знаменатель не больше трёх.
# common.py · psycopg 3.2.3 · ollama 0.6.0 · pgvector 0.8.0 · PostgreSQL 16
import os
import re
from functools import lru_cache

import ollama
import psycopg

DSN = os.environ.get("DATABASE_URL", "postgresql://rag:rag@127.0.0.1:5432/rag")
OLLAMA_HOST = os.environ.get("OLLAMA_HOST", "http://127.0.0.1:11434")
EMBED_MODEL = os.environ.get("EMBED_MODEL", "qwen3-embedding:0.6b")
CHAT_MODEL = os.environ.get("CHAT_MODEL", "qwen3:1.7b")

client = ollama.Client(host=OLLAMA_HOST)

# id, текст, компания, тональность, тема
DOCS = [
    (1, "Цена золота на мировых рынках обновила исторический максимум на фоне спроса центробанков", None, "positive", "commodities"),
    (2, "Слитки золота подорожали, инвесторы уходят в защитные активы", None, "neutral", "commodities"),
    (3, "Добыча золота в России выросла, крупный производитель повысил прогноз", "Полюс", "positive", "commodities"),
    (4, "Банки увеличили продажи золотых слитков частным клиентам", None, "neutral", "finance"),
    (5, "Серебро и платина подорожали вслед за золотом", None, "neutral", "commodities"),
    (6, "Фигурист взял золото на чемпионате России, обновив личный рекорд", None, "positive", "sport"),
    (7, "Российская гимнастка завоевала золото на этапе Кубка мира", None, "positive", "sport"),
    (8, "Сборная по хоккею выиграла золото молодёжного турнира", None, "positive", "sport"),
    (9, "Банк России сохранил ключевую ставку на уровне 16 процентов", "ЦБ", "neutral", "monetary"),
    (10, "ЦБ повысил ключевую ставку, рынок облигаций отреагировал падением", "ЦБ", "negative", "monetary"),
    (11, "Аналитики ждут, что регулятор снизит процентную ставку на ближайшем заседании", "ЦБ", "neutral", "monetary"),
    (12, "Букмекеры приняли рекордную ставку на финал чемпионата мира по футболу", None, "neutral", "sport"),
    (13, "Игрок сделал ставку ва-банк и выиграл покерный турнир", None, "positive", "sport"),
    (14, "Ставка на молодых игроков помогла клубу выйти в плей-офф", None, "positive", "sport"),
    (15, "ОПЕК+ договорилась продлить ограничения добычи нефти", None, "neutral", "commodities"),
    (16, "Нефть Brent подешевела на фоне данных о запасах в США", None, "negative", "commodities"),
    (17, "Россия увеличила экспорт нефти в Азию", None, "positive", "commodities"),
    (18, "Сбербанк представил новую версию GigaChat для корпоративных клиентов", "Сбербанк", "positive", "tech"),
    (19, "Яндекс обновил YandexGPT и открыл доступ для разработчиков", "Яндекс", "positive", "tech"),
    (20, "Газпром сообщил о снижении чистой прибыли за квартал", "Газпром", "negative", "finance"),
    (21, "Магнит открыл новые магазины в регионах", "Магнит", "positive", "retail"),
    (22, "Ритейлеры жалуются на рост логистических расходов", None, "negative", "retail"),
    (23, "Сбербанк сообщил о рекордной прибыли за девять месяцев", "Сбербанк", "positive", "finance"),
    (24, "Кибератака нарушила работу платёжной системы крупного банка", None, "negative", "incident"),
    (25, "Курс рубля укрепился к юаню после решения регулятора", "ЦБ", "positive", "finance"),
    (26, "Ключевая функция нового смартфона - ночной режим камеры", None, "positive", "tech"),
    (27, "Ключ от квартиры получили первые жильцы нового дома", None, "positive", "realty"),
    (28, "Бронзовую медаль завоевала теннисистка из Казани", None, "positive", "sport"),
    (29, "Минфин разместил облигации федерального займа на 100 миллиардов рублей", "Минфин", "neutral", "finance"),
    (30, "Энергетики сообщили о росте потребления электроэнергии в регионах", None, "neutral", "energy"),
]
TEXT = {d[0]: d[1] for d in DOCS}

# запрос, множество релевантных id
QUERIES = [
    ("золото цена", {1, 2, 5}),
    ("золото соревнования", {6, 7, 8}),
    ("золотая медаль", {6, 7, 8}),
    ("подорожание драгоценных металлов", {1, 2, 5}),
    ("ключевая ставка ЦБ", {9, 10, 11}),
    ("что решил регулятор по процентам", {9, 10, 11}),
    ("ставка на спорт", {12, 13}),
    ("ОПЕК", {15}),
    ("добыча нефти", {15, 17}),
    ("нейросеть для бизнеса", {18, 19}),
    ("рекордная прибыль банка", {23}),
    ("ключ от квартиры", {27}),
]

SYSTEM = (
    "Ты аналитик новостной базы. Для вопросов о содержании новостей вызывай search_articles. "
    "Для вопросов со словом сколько вызывай get_metrics. "
    "Отвечай по-русски, коротко и только по данным инструментов."
)

TOOLS = [
    {"type": "function", "function": {
        "name": "search_articles",
        "description": "Гибридный поиск новостей по смыслу и по словам",
        "parameters": {"type": "object", "properties": {
            "query": {"type": "string", "description": "поисковый запрос"}}, "required": ["query"]}}},
    {"type": "function", "function": {
        "name": "get_metrics",
        "description": "Число новостей по теме. Темы: commodities, sport, monetary, tech, retail, energy, incident, finance, realty",
        "parameters": {"type": "object", "properties": {
            "topic": {"type": "string", "description": "тема новостей"}}, "required": ["topic"]}}},
]


def embed(texts):
    return client.embed(model=EMBED_MODEL, input=texts).embeddings


def vec(values):
    return "[" + ",".join(f"{x:.6f}" for x in values) + "]"


@lru_cache(maxsize=None)
def embed_query(text):
    return vec(embed([text])[0])


def ensure_loaded(conn):
    with conn.cursor() as cur:
        cur.execute("CREATE EXTENSION IF NOT EXISTS vector")
        cur.execute("SELECT to_regclass('news')")
        if cur.fetchone()[0] is not None:
            cur.execute("SELECT count(*) FROM news")
            if cur.fetchone()[0] == len(DOCS):
                return
        embeddings = embed([d[1] for d in DOCS])
        dim = len(embeddings[0])
        cur.execute("DROP TABLE IF EXISTS news")
        cur.execute(
            f"CREATE TABLE news (id int PRIMARY KEY, body text, company text, tone text, topic text, "
            f"embedding vector({dim}), "
            f"tsv tsvector GENERATED ALWAYS AS (to_tsvector('russian', body)) STORED)"
        )
        for doc, emb in zip(DOCS, embeddings):
            cur.execute(
                "INSERT INTO news (id, body, company, tone, topic, embedding) VALUES (%s, %s, %s, %s, %s, %s::vector)",
                (*doc, vec(emb)),
            )
        cur.execute("CREATE INDEX news_hnsw ON news USING hnsw (embedding vector_cosine_ops)")
        cur.execute("CREATE INDEX news_gin ON news USING gin (tsv)")


_conn = None


def db():
    global _conn
    if _conn is None:
        _conn = psycopg.connect(DSN, autocommit=True)
        ensure_loaded(_conn)
    return _conn


def search_vector(conn, query, k=10):
    with conn.cursor() as cur:
        cur.execute("SELECT id FROM news ORDER BY embedding <=> %s::vector LIMIT %s", (embed_query(query), k))
        return [row[0] for row in cur.fetchall()]


def search_lexical(conn, query, k=10):
    words = re.findall(r"\w+", query.lower())
    if not words:
        return []
    with conn.cursor() as cur:
        cur.execute(
            "SELECT id FROM news, to_tsquery('russian', %s) q WHERE tsv @@ q "
            "ORDER BY ts_rank_cd(tsv, q) DESC, id LIMIT %s",
            (" | ".join(words), k),
        )
        return [row[0] for row in cur.fetchall()]


def rrf(rankings, k=60, weights=None):
    weights = weights or [1.0] * len(rankings)
    scores = {}
    for weight, ranking in zip(weights, rankings):
        for rank, doc_id in enumerate(ranking, start=1):
            scores[doc_id] = scores.get(doc_id, 0.0) + weight / (k + rank)
    return sorted(scores, key=lambda d: (-scores[d], d))


def search_hybrid(conn, query, k=10, rrf_k=60, weights=None):
    return rrf([search_vector(conn, query, k), search_lexical(conn, query, k)], rrf_k, weights)


def recall_at(ranking, relevant, n=3):
    return len(set(ranking[:n]) & relevant) / min(n, len(relevant))


def search_articles(query):
    ids = search_hybrid(db(), query)[:3]
    return "\n".join(f"[{i}] {TEXT[i]}" for i in ids) or "ничего не найдено"


def get_metrics(topic):
    with db().cursor() as cur:
        cur.execute("SELECT count(*) FROM news WHERE topic = %s", (topic,))
        return f"Новостей по теме {topic}: {cur.fetchone()[0]}"


REGISTRY = {"search_articles": search_articles, "get_metrics": get_metrics}


def call_tool(name, args):
    func = REGISTRY.get(name)
    if func is None:
        return f"неизвестный инструмент {name}"
    try:
        return func(**args)
    except Exception as exc:
        return f"ошибка вызова {name}, {exc}"
Теперь замер. Скрипт hybrid_eval.py прогоняет 12 запросов через три режима и печатает таблицу Recall@3, а затем показывает, что каждая ветка возвращает на одиночное слово «золото». Малый корпус и малое число запросов означают, что разница в одно попадание заметно двигает среднее.
# hybrid_eval.py · psycopg 3.2.3 · ollama 0.6.0 · pgvector 0.8.0
from common import QUERIES, TEXT, db, recall_at, search_hybrid, search_lexical, search_vector

conn = db()
MODES = [("вектор", search_vector), ("лексика", search_lexical), ("RRF", search_hybrid)]

print("Recall@3 по запросам")
print(f"{'запрос':<38}{'вектор':>8}{'лексика':>9}{'RRF':>6}")
totals = [0.0, 0.0, 0.0]
for query, relevant in QUERIES:
    scores = [recall_at(func(conn, query), relevant) for _, func in MODES]
    for i, score in enumerate(scores):
        totals[i] += score
    print(f"{query:<38}{scores[0]:>8.2f}{scores[1]:>9.2f}{scores[2]:>6.2f}")
n = len(QUERIES)
print(f"{'среднее':<38}{totals[0] / n:>8.2f}{totals[1] / n:>9.2f}{totals[2] / n:>6.2f}")

print("\nТоп-3 на запрос «золото»")
for name, func in MODES:
    print(name)
    for doc_id in func(conn, "золото")[:3]:
        print("  ", doc_id, TEXT[doc_id][:60])
Recall@3 по запросам
запрос                                  вектор  лексика   RRF
золото цена                               0.67     0.67  1.00
золото соревнования                       0.00     0.00  0.00
золотая медаль                            0.33     0.00  0.33
подорожание драгоценных металлов          0.67     0.00  0.67
ключевая ставка ЦБ                        0.67     1.00  1.00
что решил регулятор по процентам          0.33     0.67  0.67
ставка на спорт                           0.50     0.00  1.00
ОПЕК                                      1.00     1.00  1.00
добыча нефти                              0.50     0.50  1.00
нейросеть для бизнеса                     0.50     0.00  0.50
рекордная прибыль банка                   1.00     0.00  1.00
ключ от квартиры                          1.00     1.00  1.00
среднее                                   0.60     0.40  0.76

Топ-3 на запрос «золото»
вектор
   5 Серебро и платина подорожали вслед за золотом
   1 Цена золота на мировых рынках обновила исторический максимум
   4 Банки увеличили продажи золотых слитков частным клиентам
лексика
   1 Цена золота на мировых рынках обновила исторический максимум
   2 Слитки золота подорожали, инвесторы уходят в защитные активы
   3 Добыча золота в России выросла, крупный производитель повыси
RRF
   1 Цена золота на мировых рынках обновила исторический максимум
   5 Серебро и платина подорожали вслед за золотом
   2 Слитки золота подорожали, инвесторы уходят в защитные активы
Средний Recall@3 на этих 12 запросах составил 0.60 у вектора, 0.40 у лексики и 0.76 у RRF. Это согласуется с идеей, что ветки дополняют друг друга, но корпус из 30 документов и 12 запросов слишком мал, чтобы говорить о значимости разницы. Из конкретных запросов видно следующее. На «ставка на спорт» гибрид дал 1.00 против 0.50 у вектора и 0.00 у лексики, на «добыча нефти» 1.00 против 0.50 у обеих веток, на «золото цена» 1.00 против 0.67.
Главную проблему из начала статьи гибрид при этом не решил. Запрос «золото соревнования» дал 0.00 во всех трёх режимах, а в топ-3 по одиночному «золото» нет ни одного спортивного документа, победило значение рынка металлов в каждой ветке, включая RRF. Общим для топ-3 обеих веток оказался только документ 1, и RRF поставил его на первое место, а следом взял документ 5 из векторной ветки и документ 2 из лексической. Поэтому наш замер не доказывает, что гибрид лечит омонимию, он показывает лишь прирост среднего на этом наборе. Про устойчивость лексической ветки к омонимам по запросу «ключ от квартиры» судить нельзя, потому что релевантен там единственный документ и все режимы дали 1.00. А на «ключевая ставка ЦБ» лексика получила 1.00, лучше вектора с его 0.67.
Теперь агент. Файл agent.py собирает граф из трёх узлов, как описано выше. Температура нулевая, режим размышлений выключен параметром think=False, чтобы маленькая модель не тратила токены на длинные рассуждения. Для каждого вопроса печатаем трассу вызовов инструментов и ответ.
# agent.py · langgraph 0.2.60 · ollama 0.6.0 · qwen3:1.7b
import operator
import re
from typing import Annotated, TypedDict

from langgraph.graph import END, START, StateGraph

from common import CHAT_MODEL, SYSTEM, TOOLS, call_tool, client


class State(TypedDict):
    messages: Annotated[list, operator.add]
    trace: Annotated[list, operator.add]


def planner(state):
    reply = client.chat(model=CHAT_MODEL, messages=state["messages"], tools=TOOLS,
                        think=False, options={"temperature": 0})
    return {"messages": [reply.message]}


def route(state):
    return "tools" if state["messages"][-1].tool_calls else END


def run_tools(state):
    messages, trace = [], []
    for call in state["messages"][-1].tool_calls:
        args = dict(call.function.arguments)
        trace.append(f"{call.function.name}({args})")
        messages.append({"role": "tool", "tool_name": call.function.name,
                         "content": call_tool(call.function.name, args)})
    return {"messages": messages, "trace": trace}


def finalizer(state):
    reply = client.chat(model=CHAT_MODEL, messages=state["messages"],
                        think=False, options={"temperature": 0})
    return {"messages": [reply.message]}


graph = StateGraph(State)
graph.add_node("planner", planner)
graph.add_node("tools", run_tools)
graph.add_node("finalizer", finalizer)
graph.add_edge(START, "planner")
graph.add_conditional_edges("planner", route, {"tools": "tools", END: END})
graph.add_edge("tools", "finalizer")
graph.add_edge("finalizer", END)
app = graph.compile()

QUESTIONS = ["Что пишут про цену золота?", "Сколько новостей про спорт в базе?"]

for question in QUESTIONS:
    result = app.invoke({
        "messages": [{"role": "system", "content": SYSTEM}, {"role": "user", "content": question}],
        "trace": [],
    })
    answer = re.sub(r"<think>.*?</think>", "", result["messages"][-1].content or "", flags=re.S).strip()
    print("Вопрос:", question)
    print("Вызовы:", "; ".join(result["trace"]) or "инструмент не вызывали")
    print("Ответ:", answer)
    print()
/var/lib/bds-sat-python/runs/sat-python-1611/.venv/lib/python3.12/site-packages/langgraph/checkpoint/base/__init__.py:18: LangChainPendingDeprecationWarning: The default value of `allowed_objects` will change in a future version. Pass an explicit value (e.g., allowed_objects='messages' or allowed_objects='core') to suppress this warning.
  from langgraph.checkpoint.serde.jsonplus import JsonPlusSerializer
Вопрос: Что пишут про цену золота?
Вызовы: search_articles({'query': 'цену золота'})
Ответ: Цена золота подорожала на мировых рынках, серебро и платина также подорожали, инвесторы уходят в защитные активы.

Вопрос: Сколько новостей про спорт в базе?
Вызовы: get_metrics({'topic': 'sport'})
Ответ: Новостей по теме sport: 7.
На обоих вопросах qwen3:1.7b выбрала подходящий инструмент. Для первого вопроса это search_articles, и ответ собран из найденных документов. Для второго это get_metrics с темой sport, и ответ взят из результата подсчёта. Два вопроса это очень мало, и они не говорят о надёжности выбора в целом. Если модель не вызвала инструмент или передала странный аргумент, это будет видно в строке «Вызовы», и это честный результат, а не ошибка стенда. Для запуска такого поиска как сервиса следующим шагом обычно становится HTTP-обёртка, и её основы разбирает курс Введение в FastAPI.
Задания
Три задачи на то, чтобы покрутить параметры и расширить агента. Решения тоже запускаются на стенде.
Задание 1. Взвешенный RRF и подбор k
Добавьте веса для веток и переберите параметр k на размеченном наборе. Покажите, как меняется средний Recall@3.
Решение
Функция rrf в common.py уже принимает веса. Остаётся один раз получить списки обеих веток для всех запросов и перебрать сетку значений.
# task1.py · psycopg 3.2.3 · ollama 0.6.0
from common import QUERIES, db, recall_at, rrf, search_lexical, search_vector

conn = db()
cached = [(search_vector(conn, q), search_lexical(conn, q), rel) for q, rel in QUERIES]

print(f"{'k':>4} {'веса вектор/лексика':<22}{'Recall@3':>9}")
for k in (1, 10, 60):
    for weights in ((1, 1), (1, 2), (2, 1)):
        mean = sum(recall_at(rrf([v, l], k, list(weights)), rel) for v, l, rel in cached) / len(cached)
        print(f"{k:>4} {str(weights):<22}{mean:>9.3f}")
   k веса вектор/лексика    Recall@3
   1 (1, 1)                    0.722
   1 (1, 2)                    0.653
   1 (2, 1)                    0.681
  10 (1, 1)                    0.736
  10 (1, 2)                    0.764
  10 (2, 1)                    0.750
  60 (1, 1)                    0.764
  60 (1, 2)                    0.764
  60 (2, 1)                    0.792
Подбор на тех же запросах, по которым вы измеряете качество, даёт завышенную оценку. В реальной системе держите отдельный набор для проверки.
Задание 2. Другая модель в агенте
Замените qwen3:1.7b на deepseek-r1:1.5b и сравните, как каждая модель выбирает инструмент. Результат оформите таблицей вызовов.
Решение
Агент берёт имя модели из переменной окружения CHAT_MODEL, так что для целого графа достаточно запустить agent.py с другим значением. Для сравнения мы вызываем только планировщик с обеими моделями и печатаем выбранные вызовы. Ошибки ловим, потому что не каждая модель в Ollama принимает инструменты.
# task2.py · ollama 0.6.0 · qwen3:1.7b · deepseek-r1:1.5b
from common import SYSTEM, TOOLS, client

MODELS = ["qwen3:1.7b", "deepseek-r1:1.5b"]
QUESTIONS = ["Что пишут про цену золота?", "Сколько новостей про спорт в базе?"]

print(f"{'модель':<18} | {'вопрос':<30} | выбор")
for model in MODELS:
    for question in QUESTIONS:
        try:
            reply = client.chat(
                model=model,
                messages=[{"role": "system", "content": SYSTEM}, {"role": "user", "content": question}],
                tools=TOOLS, think=False, options={"temperature": 0},
            )
            calls = reply.message.tool_calls or []
            shown = ", ".join(f"{c.function.name}({dict(c.function.arguments)})" for c in calls) or "без вызова"
        except Exception as exc:
            shown = f"ошибка {type(exc).__name__}, {str(exc)[:70]}"
        print(f"{model:<18} | {question:<30} | {shown}")
модель             | вопрос                         | выбор
qwen3:1.7b         | Что пишут про цену золота?     | search_articles({'query': 'цену золота'})
qwen3:1.7b         | Сколько новостей про спорт в базе? | get_metrics({'topic': 'sport'})
deepseek-r1:1.5b   | Что пишут про цену золота?     | без вызова
deepseek-r1:1.5b   | Сколько новостей про спорт в базе? | без вызова
На двух вопросах и при вызове с think=False и температурой 0 deepseek-r1:1.5b инструмент не вызвала ни разу, а qwen3:1.7b вызвала оба раза. Почему так вышло, прогон не выясняет. Причиной может быть сама модель, отключённый режим размышлений или шаблон запроса в этой сборке Ollama, поэтому вывод относится только к этим условиям, а не ко всей семье моделей.
Задание 3. Третий инструмент search_by_entity
Добавьте инструмент с фильтром по компании и тональности в SQL и проверьте, что агент выбирает его на вопрос «Есть ли негативные новости про ЦБ?».
Решение
Новый инструмент регистрируется в REGISTRY, его схема добавляется к списку TOOLS, а системный промпт дополняется подсказкой с допустимыми значениями. Агент здесь выполняется одним шагом, чтобы было видно, что выбрала модель.
# task3.py · psycopg 3.2.3 · ollama 0.6.0 · qwen3:1.7b
from common import CHAT_MODEL, REGISTRY, SYSTEM, TOOLS, call_tool, client, db


def search_by_entity(company="", tone=""):
    with db().cursor() as cur:
        cur.execute(
            "SELECT id, tone, body FROM news "
            "WHERE (%s = '' OR company = %s) AND (%s = '' OR tone = %s) ORDER BY id LIMIT 5",
            (company, company, tone, tone),
        )
        rows = cur.fetchall()
    return "\n".join(f"[{i}] ({t}) {b}" for i, t, b in rows) or "ничего не найдено"


REGISTRY["search_by_entity"] = search_by_entity
ENTITY_TOOL = {"type": "function", "function": {
    "name": "search_by_entity",
    "description": "Новости по компании и тональности. Компании ЦБ, Сбербанк, Яндекс, Газпром, Магнит, Минфин, Полюс",
    "parameters": {"type": "object", "properties": {
        "company": {"type": "string", "description": "название компании"},
        "tone": {"type": "string", "enum": ["positive", "negative", "neutral"]}}}}}

system = SYSTEM + " Для фильтра по компании и тональности вызывай search_by_entity."
question = "Есть ли негативные новости про ЦБ?"
reply = client.chat(
    model=CHAT_MODEL,
    messages=[{"role": "system", "content": system}, {"role": "user", "content": question}],
    tools=TOOLS + [ENTITY_TOOL], think=False, options={"temperature": 0},
)
print("Вопрос:", question)
for call in reply.message.tool_calls or []:
    args = dict(call.function.arguments)
    print("Вызов:", call.function.name, args)
    print(call_tool(call.function.name, args))
if not reply.message.tool_calls:
    print("Инструмент не вызван")
Вопрос: Есть ли негативные новости про ЦБ?
Вызов: search_by_entity {'company': 'ЦБ', 'tone': 'negative'}
[10] (negative) ЦБ повысил ключевую ставку, рынок облигаций отреагировал падением
Если модель выбрала search_articles вместо нового инструмента, усильте описание инструмента или добавьте в промпт пример. Для маленькой модели формулировка описания влияет на выбор сильнее, чем кажется.
Что дальше
Гибридный поиск на Postgres и локальной модели собирается за вечер, а вот качество агента и устойчивость такого сервиса требуют системной работы, от оценки поиска до деплоя и мониторинга. Если хотите пройти этот путь на практике, посмотрите курс AI-агенты для оптимизации бизнес-процессов, где разбираются агенты с инструментами, графы состояний и работа с открытыми моделями.