Ollama tool calling решает конкретную задачу инженера, у которого локальная модель знает мир только до даты заморозки обучающих данных. На вопрос про релиз прошлой недели она начнёт угадывать. Если дать модели набор функций и цикл, который их выполняет, она сама решит, когда нужны свежие данные, и получит их из поиска. В статье мы разберём механизм вызова функций, сравним его с RAG и ручной подстановкой контекста, а затем воспроизведём цикл на стенде с малой моделью Qwen3 и локальным поисковым сервисом, без внешних ключей. Исходное руководство опирается на платный API NestDaddy, а мы его заменим. Отдельно посмотрим, где малая модель ошиблась прямо в нашем прогоне.
Что разобрано в исходнике
Автор руководства Give a local LLM live web search and news with Ollama and Python собирает исследовательского ассистента примерно на сто строк Python. У ассистента три функции. Первая ищет в вебе факты и документацию, вторая ищет свежие новости по ключевым словам, числу дней и стране, третья читает страницу целиком, когда сниппета мало. Модель в примере qwen3:8b, данные приходят из платного поискового API NestDaddy с пробным ключом на семь дней.
Суть руководства в двух идеях. Первая касается описания функций. Ollama Python library берёт имя функции, аннотации типов и docstring в стиле Google, а docstring автор советует писать для модели, то есть указывать не только что делает функция, но и когда её звать. Вторая идея касается цикла. Модель отвечает либо текстом, и тогда работа закончена, либо одним или несколькими вызовами функций. Код выполняет вызовы, добавляет каждый результат в историю сообщений с ролью tool и спрашивает модель снова, пока не придёт текст или не кончится лимит шагов.
Ещё автор советует возвращать маленький чистый JSON, ограничивать аргументы (модель иногда просит 50 результатов или 999 дней) и обрезать длинные страницы. Эти приёмы мы сохраним, а зависимость от платного API уберём. На стенде работает маленький сервис на FastAPI с учебной базой документов и новостей, поэтому в центре остаётся сам механизм, а не поставщик данных.
Как работает tool calling в Ollama под капотом
Чтобы отлаживать агента, полезно понимать, что уходит в модель и что из неё возвращается. Ниже два слоя. Сначала превращение функции в описание инструмента, затем формат сообщений в цикле.
Как функция Python становится описанием инструмента
Когда в вызов chat передаётся список функций в параметре tools, библиотека строит из них описание инструментов по имени, аннотациям типов и docstring. Модель ориентируется именно на это описание, поэтому docstring работает как промпт. Если в нём не сказано, что функция news_search нужна для событий последних дней, малая модель может ошибиться в выборе инструмента.
Аргументы приходят от модели, и доверять им нельзя. Защиту из задания 2 мы проверили искусственным вызовом, где число дней передано строкой «много». Модель такого аргумента не присылала, мы подставили его сами, и вызов упал на преобразовании в int. Это не пример ошибки модели. Проверялось только, что функция запуска инструмента возвращает строку с текстом ошибки и программа не падает. Как модель отреагирует на такой текст, мы не проверяли.
Формат tool_calls и роль tool
Ответ модели в Ollama содержит сообщение с ролью assistant. Если модель решила вызвать функции, в сообщении есть поле tool_calls, и в каждом элементе лежат имя функции и словарь аргументов. Код добавляет это сообщение в историю как есть, затем выполняет функции и добавляет по одному сообщению с ролью tool на каждый вызов. Как и в исходнике, мы кладём в такое сообщение поле tool_name с именем вызванной функции.
Через совместимый с OpenAI эндпоинт /v1/chat/completions то же самое выглядит иначе. Документация Ollama перечисляет Tools и tool_choice среди поддерживаемых возможностей и полей запроса. В задании 3 мы вручную разбираем аргументы вызова из строки JSON, а результат связываем с вызовом через идентификатор вызова. Общую картину цикла показывает схема.
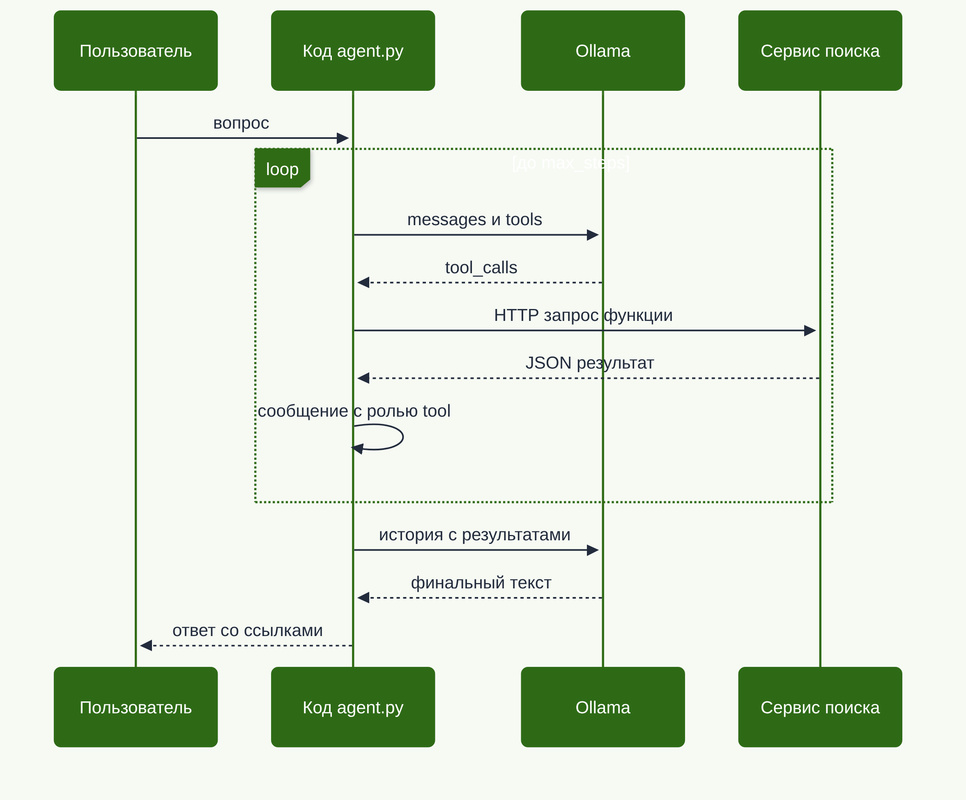
У модели нет прямого доступа к сети. Все обращения к сервису делает код агента, а модель только просит о них. Поэтому границу безопасности вы определяете сами, то есть выбираете, какие функции выдать, какие аргументы пропустить и сколько шагов разрешить.
Tool calling против RAG и ручной подстановки контекста
Свежие данные можно дать модели не только через вызов функций. Для небольших проектов иногда хватает схемы попроще, и это стоит проверить до того, как писать цикл. Сравним три подхода.
| Критерий | Tool calling в Ollama | RAG с векторным поиском | Ручная подстановка текста в промпт |
|---|---|---|---|
| Кто решает, когда нужны данные | Модель | Код ретривера на каждый запрос | Разработчик заранее |
| Число обращений к модели | Два и больше, в наших прогонах шаг с вызовами и итоговый ответ | Одно | Одно |
| Требования к модели | Поддержка инструментов в модели | Любая модель | Любая модель |
| Устойчивость на малых моделях | Зависит от модели, в наших запусках были пропущенные и плохие аргументы | Не зависит от выбора инструмента | Не зависит от выбора инструмента |
| Приватность | Данные остаются локально | Локально при локальном индексе | Локально |
| Сложность кода | Цикл, описания функций, защита | Индекс, эмбеддинги, чанкинг | Минимальная |
| Пригодность для живых новостей | Да, если функция ходит к источнику | Только при регулярном обновлении индекса | Только вручную |
Если ответы всегда нужны из одного известного документа, ручная подстановка выигрывает, потому что делает один вызов и не зависит от выбора инструмента. Если корпус большой и стабильный, лучше RAG, потому что поиск выполняется до модели и малой модели не нужно правильно сформировать аргументы. Tool calling выигрывает там, где заранее неизвестно, какие данные понадобятся и понадобятся ли вообще, например в вопросах про новости, цены и состояние систем. Цена за это в числе обращений к модели и в устойчивости. Под лимит памяти стенда в 4,5 ГБ для Ollama мы взяли малую qwen3:1.7b, и именно её слабости видны в выводе ниже. Другие модели на этом стенде мы не проверяли.
Ограничения малых моделей и защита цикла
Модель масштаба 1,7 миллиарда параметров умеет вызывать функции, но с оговорками. Их удобно держать в голове при проектировании цикла.
- Неверный выбор инструмента. Малая модель может позвать поиск по документации вместо поиска новостей. Лечится подробным docstring и коротким системным промптом.
- Плохие аргументы. Модель присылает целое предложение вместо ключевых слов, пропускает необязательный параметр или путает язык запроса. Лечится приведением типов, ограничением диапазонов и возвратом текста ошибки.
- Пропущенные шаги. Системный промпт может требовать прочитать страницу, а модель отвечает по сниппетам. Лечится проверкой в коде, а не просьбой в промпте.
- Зацикливание. Модель повторяет один и тот же вызов, не получив нужного. Лечится лимитом шагов и счётчиком одинаковых вызовов.
- Нехватка контекста. По документации Ollama окно контекста по умолчанию составляет 4096 токенов, и его можно менять переменной OLLAMA_CONTEXT_LENGTH или параметром num_ctx. Длинная страница в результате вызова вытесняет историю, поэтому результаты нужно обрезать.
Ошибка инструмента возвращается модели текстом, а не поднимается исключением наверх, потому что у модели есть шанс исправить вызов. Лимит шагов остаётся последней линией защиты. В нашем прогоне и заданиях проявились два пункта из пяти, плохие аргументы и пропущенные шаги, а остальные три приведены по общим соображениям и в наших запусках не наблюдались. Курс AI-агенты для оптимизации бизнес-процессов разбирает такие циклы на более крупных сценариях.
Практика, агент на Qwen3 с локальным поисковым сервисом на FastAPI
Стенд состоит из двух контейнеров. Первый это Ollama из кэша стенда, в котором через ollama pull скачивается qwen3:1.7b. Второй это образ Python с сервисом на FastAPI, отдающим эндпоинты /search, /news и /page. Сам агент запускается из виртуального окружения на хосте и ходит в оба контейнера по портам на 127.0.0.1. Лимиты памяти 4500 МБ для Ollama и 1 ГБ для сервиса, всего около 5,5 ГБ, GPU на стенде не используется. Основы FastAPI, которые понадобятся для сервиса, разбирает курс Введение в FastAPI.
Начнём с описания стенда. Сервис поиска ставит зависимости при старте контейнера и берёт файлы из текущей папки.
# compose.yaml · Docker Compose · ollama/ollama 0.40.13 · python 3.13.18
services:
  ollama:
    image: ollama/ollama:0.40.13
    mem_limit: 4500m
    tmpfs:
      - /root/.ollama:size=2500m
    ports:
      - "127.0.0.1:11435:11434"
    healthcheck:
      test: ["CMD", "ollama", "list"]
      interval: 5s
      timeout: 5s
      retries: 20
  search:
    image: python:3.13.18-slim-bookworm
    mem_limit: 1g
    working_dir: /app
    volumes:
      - ./:/app:ro
    command: sh -c "pip install -q -r requirements.txt && uvicorn server:app --host 0.0.0.0 --port 8000"
    ports:
      - "127.0.0.1:8000:8000"
# requirements.txt
ollama==0.6.0
requests==2.32.3
fastapi==0.115.6
uvicorn==0.34.0
Теперь сам сервис. База учебная, про вымышленную библиотеку «Зефир», чтобы модель не могла ответить из собственной памяти. Поиск примитивный, по совпадению начала слов, и этого достаточно для демонстрации цикла. Значение age_days в новостях заменяет дату публикации, и по нему работает фильтр по числу дней.
# server.py · fastapi 0.115.6 · uvicorn 0.34.0 · python 3.13.18
from fastapi import FastAPI, HTTPException, Query

app = FastAPI(title="Local search")

DOCS = [
    {
        "url": "https://docs.local/zefir/overview",
        "title": "Зефир, обзор библиотеки",
        "text": "Зефир это учебная библиотека для проверки таблиц перед обучением моделей. "
                "Версия 2.0 переписала ядро проверок и требует Python 3.10 и новее.",
    },
    {
        "url": "https://docs.local/zefir/migration",
        "title": "Зефир, миграция с версии 1.x на 2.0",
        "text": "При миграции с версии 1.x функция check_table переименована в validate. "
                "Параметр strict теперь включён по умолчанию. Старые конфиги нужно "
                "пересохранить командой zefir convert.",
    },
    {
        "url": "https://docs.local/zefir/cli",
        "title": "Зефир, командная строка",
        "text": "Команда zefir run проверяет таблицу и печатает отчёт. "
                "Флаг --report задаёт формат отчёта.",
    },
]

NEWS = [
    {
        "url": "https://news.local/zefir-2-1-beta",
        "title": "Зефир 2.1 beta добавила проверки временных рядов",
        "source": "news.local",
        "age_days": 2,
        "description": "Бета-версия Зефир 2.1 получила проверки пропусков во временных рядах.",
    },
    {
        "url": "https://news.local/zefir-2-0-release",
        "title": "Вышла библиотека Зефир 2.0",
        "source": "news.local",
        "age_days": 6,
        "description": "Релиз Зефир 2.0 принёс новое ядро проверок и переименование функций.",
    },
    {
        "url": "https://news.local/zefir-1-9-eol",
        "title": "Поддержка Зефир 1.9 завершается",
        "source": "news.local",
        "age_days": 40,
        "description": "Ветка Зефир 1.9 больше не получает исправлений.",
    },
]


def score(query: str, text: str) -> int:
    low = text.lower()
    words = [w[:5] for w in query.lower().split() if len(w) > 2]
    return sum(1 for w in words if w in low)


@app.get("/health")
def health():
    return {"status": "ok"}


@app.get("/search")
def search(q: str, limit: int = Query(5, ge=1, le=10)):
    found = []
    for doc in DOCS:
        s = score(q, doc["title"] + " " + doc["text"])
        if s > 0:
            found.append((s, doc))
    found.sort(key=lambda x: -x[0])
    return {
        "results": [
            {"title": d["title"], "url": d["url"], "snippet": d["text"][:120]}
            for _, d in found[:limit]
        ]
    }


@app.get("/news")
def news(q: str, days: int = Query(7, ge=1, le=120)):
    found = []
    for item in NEWS:
        if item["age_days"] > days:
            continue
        s = score(q, item["title"] + " " + item["description"])
        if s > 0:
            found.append((s, item))
    found.sort(key=lambda x: -x[0])
    return {"results": [item for _, item in found[:8]]}


@app.get("/page")
def page(url: str):
    for doc in DOCS:
        if doc["url"] == url:
            return {"text": doc["text"]}
    raise HTTPException(status_code=404, detail="page not found")
Теперь агент. Три функции построены по рекомендациям исходника. Docstring подсказывает модели, когда звать функцию, аргументы ограничены по диапазону, результат обрезан. Параметр think со значением False мы передаём, чтобы модель не тратила токены на рассуждения перед ответом. В выводе прогона блоков рассуждений нет, но отдельной проверки этого параметра мы не делали. Лог печатает каждый вызов с аргументами, поэтому по выводу видно, какие инструменты выбрала малая модель.
# agent.py · ollama 0.6.0 · requests 2.32.3 · Ollama 0.40.13 · qwen3:1.7b
import json
import os
import sys

import ollama
import requests

BASE = os.environ.get("SEARCH_URL", "http://127.0.0.1:8000")
MODEL = os.environ.get("OLLAMA_MODEL", "qwen3:1.7b")
client = ollama.Client(host=os.environ.get("OLLAMA_URL", "http://127.0.0.1:11435"))


def _get(path, **params):
    r = requests.get(
        f"{BASE}/{path}",
        params={k: v for k, v in params.items() if v is not None},
        timeout=30,
    )
    r.raise_for_status()
    return r.json()


def web_search(query: str, limit: int = 5) -> str:
    """Search the documentation base. Use it for guides, migration notes and how-to questions.

    Args:
        query: Short key words in Russian, like a search box query.
        limit: Number of results, 1 to 10.

    Returns:
        JSON list of results with title, url and snippet.
    """
    data = _get("search", q=query, limit=max(1, min(int(limit), 10)))
    return json.dumps(data["results"], ensure_ascii=False)


def news_search(query: str, days: int = 7) -> str:
    """Search recent news. Use it for releases, events and anything that happened lately.

    Args:
        query: Key words in Russian, for example a library or company name.
        days: How many days back to search, 1 to 120.

    Returns:
        JSON list of articles with title, source, url and description.
    """
    data = _get("news", q=query, days=max(1, min(int(days), 120)))
    return json.dumps(data["results"], ensure_ascii=False)


def read_page(url: str) -> str:
    """Read the full text of a page. Use it after a search when a snippet is not enough.

    Args:
        url: The full URL of the page, taken from search results.

    Returns:
        The page text, cut to 3000 characters.
    """
    return (_get("page", url=url).get("text") or "")[:3000]


TOOLS = {f.__name__: f for f in (web_search, news_search, read_page)}

SYSTEM = (
    "Ты помощник-исследователь с доступом к локальной базе знаний. "
    "Для свежих событий используй news_search, для документации web_search. "
    "Перед подробным ответом прочитай одну лучшую страницу через read_page. "
    "Отвечай по-русски, коротко, и перечисли использованные url."
)


def ask(question: str, max_steps: int = 6, tools=None) -> str:
    tools = tools or TOOLS
    messages = [
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": question},
    ]
    for step in range(1, max_steps + 1):
        response = client.chat(
            model=MODEL, messages=messages, tools=list(tools.values()), think=False
        )
        messages.append(response.message)
        calls = response.message.tool_calls or []
        if not calls:
            return response.message.content
        for call in calls:
            name = call.function.name
            args = dict(call.function.arguments)
            print(f"[шаг {step}] {name}({json.dumps(args, ensure_ascii=False)})")
            fn = tools.get(name)
            try:
                output = fn(**args) if fn else f"unknown tool {name}"
            except Exception as exc:  # ошибку возвращаем модели
                output = f"tool error: {exc}"
            print(f"[результат] {output[:100]}")
            messages.append({"role": "tool", "content": output, "tool_name": name})
    return "Stopped after too many tool calls."


if __name__ == "__main__":
    question = " ".join(sys.argv[1:]) or (
        "Что нового в библиотеке Зефир за последние 10 дней и как мигрировать с версии 1.x?"
    )
    print("Вопрос", question)
    print("Ответ", ask(question))
Скрипт запуска поднимает стенд, ждёт готовности обоих сервисов, скачивает модель, ставит зависимости в .venv и запускает агента. Остановку стенда выполняет раннер.
#!/usr/bin/env bash
# run.sh · Docker Compose · ollama/ollama 0.40.13 · python 3.13.18
set -euo pipefail
docker compose up -d
until docker compose exec -T ollama ollama list >/dev/null 2>&1; do sleep 2; done
docker compose exec -T ollama ollama pull qwen3:1.7b
until curl -sf http://127.0.0.1:8000/health >/dev/null; do sleep 2; done
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python agent.py
Вывод агента ниже.
Вопрос Что нового в библиотеке Зефир за последние 10 дней и как мигрировать с версии 1.x?
[шаг 1] news_search({"query": "Зефир 10 дней"})
[результат] [{"url": "https://news.local/zefir-2-1-beta", "title": "Зефир 2.1 beta добавила проверки временных р
[шаг 1] web_search({"query": "мigration from 1.x to Zefir"})
[результат] [{"title": "Зефир, миграция с версии 1.x на 2.0", "url": "https://docs.local/zefir/migration", "snip
Ответ Использованные URL:
1. https://news.local/zefir-2-1-beta
2. https://news.local/zefir-2-0-release
3. https://docs.local/zefir/migration
4. https://docs.local/zefir/cli

Новые изменения в библиотеке Зефир за последние 10 дней:
- В версии 2.1 добавлена проверка пропусков во временных рядах.
- В версии 2.0 внесены изменения в функции, такие как переименование `check_table` в `validate` и включение параметра `strict` по умолчанию.

Миграция с версии 1.x на 2.0:
- Функция `check_table` переименована в `validate`.
- Параметр `strict` теперь включён по умолчанию.
Цикл отработал и дал по существу верный ответ, но в нём видны четыре слабости малой модели.
- Плохой аргумент. Во втором вызове запрос «мigration from 1.x to Zefir» смешивает кириллическую букву и английские слова, хотя docstring просил русские ключевые слова. Нужная страница всё же нашлась. Судя по коду оценки, вероятно, сработал латинский фрагмент 1.x, который есть в тексте документа, а вовсе не понимание запроса. Лог обрезан, поэтому полный состав результатов он не показывает.
- Пропущенный необязательный параметр. Вопрос говорил про десять дней, а вызов
news_searchушёл без аргумента days, и сработало значение по умолчанию, семь дней. Здесь это ничего не испортило, потому что обе нужные новости свежее семи дней. - Лишний адрес в списке. В список использованных url попала страница про командную строку, хотя в ответе нет ни одного факта из неё. Вероятно, она пришла в результатах поиска, но из обрезанного лога это не видно, поэтому прогон ничего не доказывает.
- Пропущенный шаг. Системный промпт требует прочитать лучшую страницу через
read_page, но модель этого не сделала и ответила по сниппетам. Здесь сниппета хватило, ответ про переименованиеcheck_tableи параметр strict в него целиком входит. На длинной странице такая экономия привела бы к потере деталей.
Один прогон не измеряет надёжность qwen3:1.7b, для этого нужна серия вопросов и подсчёт долей верных вызовов. Зато он показывает, что требования промпта (прочитай страницу, перечисли только использованные url) модель выполняет не гарантированно и проверять их надо кодом. Если ошибки с аргументами будут стабильными, можно попробовать qwen3:4b, но это увеличит память и время ответа.
Задания
Каждое задание опирается на файл agent.py и запускается на том же стенде. Решения выложены целиком и тоже прогонялись. Во всех заданиях по одному запуску, поэтому выводы ниже описывают именно эти запуски.
Задание 1. Второй инструмент и вопрос на два вызова
Добавьте функцию-калькулятор, подскажите модели через docstring, когда её звать, и задайте вопрос, которому нужны оба инструмента подряд.
▶ Решение (нажмите, чтобы открыть)
# agent_calc.py · ollama 0.6.0 · Ollama 0.40.13 · qwen3:1.7b
from agent import TOOLS, ask


def calculator(a: float, b: float, op: str = "mul") -> str:
    """Do arithmetic on two numbers. Use it for any calculation, never count in your head.

    Args:
        a: First number.
        b: Second number.
        op: One of add, sub, mul, div.

    Returns:
        The result as text.
    """
    ops = {
        "add": lambda x, y: x + y,
        "sub": lambda x, y: x - y,
        "mul": lambda x, y: x * y,
        "div": lambda x, y: x / y,
    }
    if op not in ops:
        return f"tool error: unknown op {op}"
    return str(ops[op](float(a), float(b)))


tools = {**TOOLS, "calculator": calculator}
question = "Сколько будет 17 умножить на 23, и что нового в библиотеке Зефир за последние 3 дня?"
print("Вопрос", question)
print("Ответ", ask(question, tools=tools))
Вопрос Сколько будет 17 умножить на 23, и что нового в библиотеке Зефир за последние 3 дня?
[шаг 1] calculator({"a": 17, "b": 23, "op": "mul"})
[результат] 391.0
[шаг 1] news_search({"query": "библиотека Зефир"})
[результат] [{"url": "https://news.local/zefir-2-0-release", "title": "Вышла библиотека Зефир 2.0", "source": "n
Ответ 17 умножить на 23 равно 391.
За последние 3 дня библиотека Зефир вышла 2.0 и 2.1 beta-версии, которые принесли новые функции и улучшения.
Калькулятор вызван верно, а вот новостной вызов нельзя считать успехом. Модель проигнорировала «3 дня» и не передала аргумент days. Релиз 2.0 вышел шесть дней назад и в окно из трёх дней не входит, но в ответе назван событием последних трёх дней. Вывод не показывает аргументы вызова и состав результатов. Что действовало окно в семь дней по умолчанию, мы выводим из кода агента и сервиса, а не из лога, поэтому причину прогон не доказывает. Возможно, сработало окно в семь дней по умолчанию, возможно, модель неточно пересказала результаты, а лог содержимое результатов не показывает. В любом случае от такой ошибки защищает не промпт, а проверка в коде. Например, можно сверять числа из вопроса с аргументами вызова или требовать days обязательным параметром без значения по умолчанию.
Задание 2. Защита цикла
Добавьте проверку аргументов, обрезку результата, возврат ошибки модели и остановку при повторе одинаковых вызовов.
▶ Решение (нажмите, чтобы открыть)
# guard.py · ollama 0.6.0 · Ollama 0.40.13 · qwen3:1.7b
import inspect
import json
from collections import Counter

from agent import MODEL, SYSTEM, TOOLS, client

MAX_RESULT = 1500


def run_tool(name: str, args: dict) -> str:
    fn = TOOLS.get(name)
    if fn is None:
        return f"tool error: unknown tool {name}"
    try:
        inspect.signature(fn).bind(**args)
    except TypeError as exc:
        return f"tool error: bad arguments, {exc}"
    try:
        return str(fn(**args))[:MAX_RESULT]
    except Exception as exc:
        return f"tool error: {exc}"


def ask_safe(question: str, max_steps: int = 6, max_repeat: int = 2) -> str:
    messages = [
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": question},
    ]
    seen = Counter()
    for step in range(1, max_steps + 1):
        response = client.chat(
            model=MODEL, messages=messages, tools=list(TOOLS.values()), think=False
        )
        messages.append(response.message)
        calls = response.message.tool_calls or []
        if not calls:
            return response.message.content
        for call in calls:
            name = call.function.name
            args = dict(call.function.arguments)
            key = (name, json.dumps(args, sort_keys=True, ensure_ascii=False))
            seen[key] += 1
            if seen[key] > max_repeat:
                return f"Остановка, вызов {name} повторяется"
            print(f"[шаг {step}] {name}({json.dumps(args, ensure_ascii=False)})")
            output = run_tool(name, args)
            print(f"[результат] {output[:100]}")
            messages.append({"role": "tool", "content": output, "tool_name": name})
    return "Stopped after too many tool calls."


if __name__ == "__main__":
    print("Лишний параметр", run_tool("web_search", {"query": "Зефир", "foo": 1}))
    print("Неверный тип", run_tool("news_search", {"query": "Зефир", "days": "много"}))
    print("Неизвестный инструмент", run_tool("delete_all", {}))
    print("Ответ", ask_safe("Что нового в библиотеке Зефир за последние 10 дней?"))
Лишний параметр tool error: bad arguments, got an unexpected keyword argument 'foo'
Неверный тип tool error: invalid literal for int() with base 10: 'много'
Неизвестный инструмент tool error: unknown tool delete_all
[шаг 1] news_search({"query": "Зефир"})
[результат] [{"url": "https://news.local/zefir-2-1-beta", "title": "Зефир 2.1 beta добавила проверки временных р
Ответ Используемые URL:
1. https://news.local/zefir-2-1-beta
2. https://news.local/zefir-2-0-release

В новой версии Зефир 2.1 добавлена проверка пропусков во временных рядах, а в 2.0 была выделена новая структура проверок и переименованы функции.
Три искусственных вызова, которые мы составили сами, показывают, что функция запуска возвращает для всех трёх видов ошибок строку с текстом ошибки, а программа не падает. Как модель использует такой текст, прогон не проверял. На живом вопросе модель снова не передала days, и защита этого не заметила, потому что аргумент необязательный. Значение по умолчанию семь дней перекрыло запрошенные десять, и при более длинном окне ответ мог бы оказаться неполным. Проверка сигнатуры ловит неправильную форму вызова, но не его смысл.
Задание 3. Запрос через OpenAI-совместимый эндпоинт
Замените библиотеку ollama на прямые запросы к /v1/chat/completions с полем tools и разберите tool_calls вручную.
▶ Решение (нажмите, чтобы открыть)
# raw_http.py · requests 2.32.3 · Ollama 0.40.13 · qwen3:1.7b
import json
import os

import requests

from agent import MODEL, SYSTEM, news_search, read_page

OLLAMA = os.environ.get("OLLAMA_URL", "http://127.0.0.1:11435")
FUNCS = {"news_search": news_search, "read_page": read_page}

TOOLS_SCHEMA = [
    {
        "type": "function",
        "function": {
            "name": "news_search",
            "description": "Search recent news. Use it for releases and events that happened lately.",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "Key words in Russian"},
                    "days": {"type": "integer", "description": "Days back, 1 to 120"},
                },
                "required": ["query"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "read_page",
            "description": "Read the full text of a page after a search.",
            "parameters": {
                "type": "object",
                "properties": {"url": {"type": "string", "description": "Full URL"}},
                "required": ["url"],
            },
        },
    },
]


def ask_raw(question: str, max_steps: int = 4) -> str:
    messages = [
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": question},
    ]
    for step in range(1, max_steps + 1):
        r = requests.post(
            f"{OLLAMA}/v1/chat/completions",
            json={"model": MODEL, "messages": messages, "tools": TOOLS_SCHEMA},
            timeout=600,
        )
        r.raise_for_status()
        msg = r.json()["choices"][0]["message"]
        messages.append(msg)
        calls = msg.get("tool_calls") or []
        if not calls:
            return msg.get("content") or ""
        for call in calls:
            name = call["function"]["name"]
            args = json.loads(call["function"]["arguments"])
            print(f"[шаг {step}] {name}({json.dumps(args, ensure_ascii=False)})")
            fn = FUNCS.get(name)
            try:
                output = fn(**args) if fn else f"unknown tool {name}"
            except Exception as exc:
                output = f"tool error: {exc}"
            messages.append(
                {"role": "tool", "tool_call_id": call["id"], "content": output}
            )
    return "Stopped after too many tool calls."


if __name__ == "__main__":
    print("Ответ", ask_raw("Что нового в библиотеке Зефир за последние 10 дней?"))
[шаг 1] news_search({"query": "зефир библиотека изменений", "days": 10})
Ответ Информация по новостям:
1. Релиз Зефир 2.0 с новым ядром проверок и переименованием функций (6 дней)
2. Бета-версия Зефир 2.1 с проверками временных рядов (2 дня)

Ключевые события:
- Введение нового архитектурного ядра в версии 2.0
- Добавление функций для анализа временных рядов в бета-версии 2.1
Здесь модель передала days равным 10, и в этом запуске ответ согласуется с данными сервиса, ведь в нём названы релиз 2.0 (6 дней) и бета 2.1 (2 дня). Это один запуск, а содержимое результатов в логе обрезано. Всего в основном прогоне и заданиях было четыре вызова news_search. В основном прогоне и в заданиях 1 и 2 модель вызвала news_search без days, хотя вопросы называли срок. Только в задании 3 вызов пришёл с days равным 10. Четыре вызова слишком мало, чтобы говорить о доле верных вызовов или о закономерности, но они подсказывают, где искать проблему при настройке агента.
Если вы хотите разобрать такие циклы на реальных процессах, от выбора инструментов до контроля качества ответов, посмотрите курс AI-агенты для оптимизации бизнес-процессов. В нём собран путь от простого цикла к агентам, которые встраиваются в рабочие системы.