Claude Code часто упирается в лимиты аккаунта и внешний API. Локальный контур на Ollama и Qwen оставляет запросы в контуре и даёт инженеру контроль над инструментами.
Как собрать локальный контур вместо облачного агента
Задача не в том, чтобы повторить облачную IDE, а в том, чтобы заменить внешний API предсказуемым local endpoint. Инженер получает историю диалога, системный промпт, набор инструментов и правило безопасности. Ollama поднимает модель в контейнере. Python слой собирает prompt, вызывает endpoint и исполняет только разрешённые команды. Qwen на малом размере подходит для демонстрации на CPU, а крупные модели и облачные сервисы остаются в теории.
Облачные GigaChat, YandexGPT и Kolmogorov.ai остаются вариантом для больших запросов, но на CPU стенде их не запускают как локальную модель. Генеративные сервисы вроде Kandinsky тоже решают другую задачу, поэтому в контуре остаётся текстовая модель и Python слой.
Важно разделить слой генерации текста и слой исполнения. Модель может написать команду, но сама команду не запускает. Запуск берёт на себя harness. Permission gate проверяет команду до subprocess. Такой контур можно собрать на открытых моделях и на облачных сервисах, но local endpoint снижает зависимость от сети и позволяет включить OLLAMA_NO_CLOUD.
Как агент держит контекст и вызывает инструменты
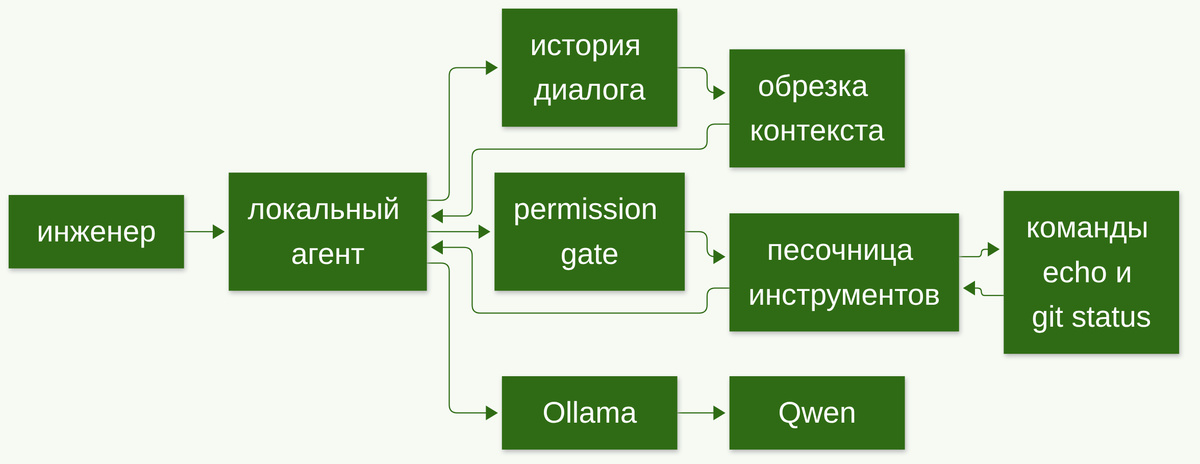
Контекст агента это не одна большая строка, а список сообщений с ролями. Системный промпт задаёт правила поведения. Пользовательские и ассистентские сообщения хранят ходы диалога. Когда история растёт, нужно выбрать, какие сообщения попадают в prompt. Простейший режим оставляет системный промпт и два последних хода. Он работает как грубая отсечка, но держит request в памяти CPU стенда.
Инструменты нужны, чтобы агент не оставался текстовой подсказкой. Для кодинга обычно требуют read file, edit file, run command и tests. На стенде мы показываем узкий набор, echo и git status. Опасные команды вида rm не проходят через gate. В выводе видно, что gate сначала классифицирует команду, а только потом вызывает subprocess.
Ниже схема цикла. Инженер даёт задачу, агент собирает prompt, permission gate проверяет команду, песочница исполняет безопасные действия, а история диалога возвращается в контекст.
Что показывает OpenAI совместимый endpoint
Ollama отдаёт endpoint, похожий на OpenAI Chat Completions. Клиент отправляет JSON с полями model, messages, max_tokens, temperature и при необходимости tools. API key для local server можно задать значением ollama, он не используется для авторизации. Такой контракт удобен тем, что агентский слой не привязан к одному SDK.
Для агентных инструментов важен другой слой. Anthropic compatible endpoint позволяет существующим инструментам с Anthropic API указать ANTHROPIC_BASE_URL на контейнер Ollama. Документация Ollama называет такое подключение совместимым API, а не полным повторением всех возможностей облачного сервиса.
Сравнение способов запуска локального агента
Локальный агент не равен одному процессу. Можно держать модель в контейнере, можно писать свой loop на Python, можно оборачивать endpoint сервисом. Ниже компактная таблица вариантов из инженерной практики.
| Вариант | API | Запуск | Инструменты | Ограничения |
|---|---|---|---|---|
| Ollama и Qwen | OpenAI compatible endpoint | container и pull model | tools, sandbox, gate | малая модель CPU |
llama.cpp server |
HTTP inference | local binary | custom tool loop | нет готового агента |
| LangGraph agent | client library | Python package | graph nodes and tools | нужен свой контур |
| FastAPI proxy | REST proxy | Python service | route middleware | нет диалога внутри |
| Anthropic bridge | Anthropic compatible endpoint | env vars for agent | existing tool loop | подмножество API |
Для статьи и стенда выбран первый вариант. Ollama закрывает запуск модели, а Python скрипт отвечает за permission gate и trim. LangGraph полезен, когда нужен явный граф состояний. FastAPI proxy подходит, если агент становится сетевым сервисом. Anthropic bridge интересен для запуска существующего агента, но его возможности проверяют по документации, а не по числам на CPU.
Практика на стенде с Ollama и Qwen
Стенд состоит из одного Ollama контейнера и Python окружения на хосте раннера. Контейнер публикует порт 11434 только на 127.0.0.1. Модель Qwen с тегом 0.6b тянется в прогоне и остаётся в named volume между стартами compose. В статье нет предсказания ответа модели, вывод появится после реального запуска стенда.
# compose.yaml · ollama/ollama 0.40.13
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: local_agent_ollama
    mem_limit: 4g
    ports:
      - "127.0.0.1:11434:11434"
    environment:
      OLLAMA_HOST: "0.0.0.0:11434"
      OLLAMA_NO_CLOUD: "1"
    volumes:
      - ollama:/root/.ollama
volumes:
  ollama:
В файле есть только комментарий. Python код работает на стандартной библиотеке и не требует внешних зависимостей.
# requirements.txt · Python stdlib
Скрипт поднимает Ollama, ждёт endpoint, тянет малую модель и запускает main.py. Проверка endpoint использует curl, а venv создаётся на хосте. Если модуль venv недоступен, скрипт делает .venv/bin/python как ссылку на python3.
#!/usr/bin/env bash
# run.sh · bash
set -euo pipefail

docker compose up -d ollama

for i in $(seq 1 120); do
  if curl -fsS http://127.0.0.1:11434/api/version >/dev/null; then
    break
  fi
  sleep 1
done

docker compose exec -T ollama ollama pull qwen3:0.6b

if python3 -m venv --without-pip .venv; then
  true
else
  mkdir -p .venv/bin
  ln -sf "$(command -v python3)" .venv/bin/python
fi

.venv/bin/python main.py
Скрипт отправляет один запрос, прогоняет permission gate и считает длину истории. В выводе смотрим строки с MODEL_ANSWER_CHARS, GATE_ECHO_ALLOW, GATE_GIT_ALLOW, GATE_RM_BLOCK, RUN_ECHO, RUN_GIT, RUN_RM, CONTEXT_BEFORE и CONTEXT_AFTER.
# main.py · qwen3:0.6b · Ollama 0.40.13
import json
import os
import subprocess
import shutil
import tempfile
import urllib.error
import urllib.request

MODEL = os.environ.get("AGENT_MODEL", "qwen3:0.6b")
BASE_URL = os.environ.get("OLLAMA_BASE_URL", "http://127.0.0.1:11434/v1")
API_KEY = os.environ.get("OLLAMA_API_KEY", "ollama")
SYSTEM_PROMPT = "Ты локальный кодинг агент. Отвечай коротко и по делу. Не предлагай опасные команды."
ALLOWED_EXACT = {"git status"}
ALLOWED_PREFIXES = {"echo"}
DENIED_PREFIXES = {"rm"}

def chat(messages):
    payload = {
        "model": MODEL,
        "messages": messages,
        "max_tokens": 64,
        "temperature": 0,
    }
    request = urllib.request.Request(
        BASE_URL + "/chat/completions",
        data=json.dumps(payload).encode("utf-8"),
        headers={
            "Content-Type": "application/json",
            "Authorization": "Bearer " + API_KEY,
        },
        method="POST",
    )
    with urllib.request.urlopen(request, timeout=180) as response:
        body = json.loads(response.read().decode("utf-8"))
    return body["choices"][0]["message"]["content"].strip()

def check_command(command):
    command = command.strip()
    if not command:
        return False
    if command in ALLOWED_EXACT:
        return True
    if any(command == name or command.startswith(name + " ") for name in ALLOWED_PREFIXES):
        return True
    if any(command.startswith(name) for name in DENIED_PREFIXES):
        return False
    return False

def run_command(command):
    if not check_command(command):
        return "BLOCKED " + command
    if command in ALLOWED_EXACT:
        if shutil.which("git") is None:
            return "git status"
        with tempfile.TemporaryDirectory() as path:
            subprocess.run(["git", "init", "-q", path], check=False)
            result = subprocess.run(
                ["git", "status", "--short"],
                cwd=path,
                capture_output=True,
                text=True,
                check=False,
            )
            output = result.stdout.strip()
            return output or "empty"
    if command.startswith("echo"):
        text = command[len("echo"):].strip()
        result = subprocess.run(["echo", text], capture_output=True, text=True, check=False)
        return result.stdout.strip()
    return "ALLOWED " + command

def prompt_length(messages):
    return sum(len(str(message.get("content", ""))) for message in messages)

def trim_messages(messages, limit=6000):
    if prompt_length(messages) <= limit:
        return messages
    system = [message for message in messages if message.get("role") == "system"]
    recent = messages[-2:]
    return system + recent

print("CHECK_MAIN_MODEL", MODEL)
print("CHECK_MAIN_BASE_URL", BASE_URL)

simple_history = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": "Назови первый шаг локального агента для кода."},
]
answer = chat(simple_history)
print("MODEL_ANSWER_CHARS", len(answer))
print("MODEL_ANSWER_HEAD", answer[:80])

print("GATE_ECHO_ALLOW", check_command("echo hello"))
print("GATE_GIT_ALLOW", check_command("git status"))
print("GATE_RM_BLOCK", check_command("rm -rf /tmp/agent_demo"))
print("RUN_ECHO", run_command("echo hello"))
print("RUN_GIT", run_command("git status"))
print("RUN_RM", run_command("rm -rf /tmp/agent_demo"))

long_history = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": "A" * 4000},
    {"role": "assistant", "content": "B" * 1200},
    {"role": "user", "content": "C" * 2500},
    {"role": "assistant", "content": "D" * 900},
]
trimmed = trim_messages(long_history)
print("CONTEXT_BEFORE", prompt_length(long_history))
print("CONTEXT_AFTER", prompt_length(trimmed))
print("TRIM_KEEP_SYSTEM", trimmed[0].get("role") == "system")
print("TRIM_LAST_ROLES", [trimmed[i].get("role") for i in range(1, len(trimmed))])
[[output main.py]]
Задания и решения
Ниже три задания и решения. Каждый файл можно запустить отдельной командой .venv/bin/python ФАЙЛ после run.sh. Первый файл снова вызывает endpoint, поэтому он идёт после основного примера.
▶ Решение (нажмите, чтобы открыть)
Задание первое. Сделать один запрос к Ollama через OpenAI совместимый endpoint и передать системный промпт кодинг агента.
# task_1_one_request.py · qwen3:0.6b
import json
import os
import urllib.request

MODEL = os.environ.get("AGENT_MODEL", "qwen3:0.6b")
BASE_URL = os.environ.get("OLLAMA_BASE_URL", "http://127.0.0.1:11434/v1")
API_KEY = os.environ.get("OLLAMA_API_KEY", "ollama")
SYSTEM_PROMPT = "Ты кодинг агент. Ответь одним предложением о первом шаге локального контура."

payload = {
    "model": MODEL,
    "messages": [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": "Назови первый шаг локального агента для кода."},
    ],
    "max_tokens": 64,
    "temperature": 0,
}

request = urllib.request.Request(
    BASE_URL + "/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={
        "Content-Type": "application/json",
        "Authorization": "Bearer " + API_KEY,
    },
    method="POST",
)

with urllib.request.urlopen(request, timeout=180) as response:
    body = json.loads(response.read().decode("utf-8"))

answer = body["choices"][0]["message"]["content"].strip()
print("TASK1_MODEL", MODEL)
print("TASK1_ANSWER_CHARS", len(answer))
print("TASK1_ANSWER_HEAD", answer[:80])
[[output task_1_one_request.py]]
▶ Решение (нажмите, чтобы открыть)
Задание второе. Реализовать permission gate для инструмента run_command, который разрешает только echo и git status, а rm отклоняет.
# task_2_permission_gate.py · stdlib
import os
import subprocess
import shutil
import tempfile

ALLOWED_EXACT = {"git status"}
ALLOWED_PREFIXES = {"echo"}
DENIED_PREFIXES = {"rm"}

def check_command(command):
    command = command.strip()
    if not command:
        return False
    if command in ALLOWED_EXACT:
        return True
    if any(command == name or command.startswith(name + " ") for name in ALLOWED_PREFIXES):
        return True
    if any(command.startswith(name) for name in DENIED_PREFIXES):
        return False
    return False

def run_allowed(command):
    if command in ALLOWED_EXACT:
        if shutil.which("git") is None:
            return "git status"
        with tempfile.TemporaryDirectory() as path:
            subprocess.run(["git", "init", "-q", path], check=False)
            result = subprocess.run(
                ["git", "status", "--short"],
                cwd=path,
                capture_output=True,
                text=True,
                check=False,
            )
            return result.stdout.strip() or "empty"
    if command.startswith("echo"):
        text = command[len("echo"):].strip()
        result = subprocess.run(["echo", text], capture_output=True, text=True, check=False)
        return result.stdout.strip()
    return "ALLOWED " + command

print("TASK2_ECHO_ALLOW", check_command("echo hello"))
print("TASK2_GIT_ALLOW", check_command("git status"))
print("TASK2_RM_BLOCK", check_command("rm -rf /tmp/agent_demo"))
print("TASK2_RUN_ECHO", run_allowed("echo hello"))
print("TASK2_RUN_GIT", run_allowed("git status"))
print("TASK2_RUN_RM", "BLOCKED" if not check_command("rm -rf /tmp/agent_demo") else "UNEXPECTED")
[[output task_2_permission_gate.py]]
▶ Решение (нажмите, чтобы открыть)
Задание третье. Сократить историю сообщений, когда суммарная длина prompt превышает 6000 символов, оставив системное сообщение и два последних хода.
# task_3_context_trim.py · stdlib
import os

LIMIT = int(os.environ.get("CONTEXT_LIMIT", "6000"))

def prompt_length(messages):
    return sum(len(str(message.get("content", ""))) for message in messages)

def trim_messages(messages, limit=LIMIT):
    if prompt_length(messages) <= limit:
        return messages
    system = [message for message in messages if message.get("role") == "system"]
    recent = messages[-2:]
    return system + recent

history = [
    {"role": "system", "content": "Ты локальный кодинг агент."},
    {"role": "user", "content": "A" * 4000},
    {"role": "assistant", "content": "B" * 1200},
    {"role": "user", "content": "C" * 2500},
    {"role": "assistant", "content": "D" * 900},
]

trimmed = trim_messages(history)
print("TASK3_LIMIT", LIMIT)
print("TASK3_BEFORE", prompt_length(history))
print("TASK3_AFTER", prompt_length(trimmed))
print("TASK3_KEEP_SYSTEM", trimmed[0].get("role") == "system")
print("TASK3_ROLES", [message.get("role") for message in trimmed])
[[output task_3_context_trim.py]]
Если нужно продолжать агентную разработку на Python и доводить контур до сервиса с тестами и наблюдаемостью, ближе всего на сайте курс AI-агенты для оптимизации бизнес-процессов. Там разбирают архитектуру агентов, инструменты и безопасные сценарии.
Референсные ссылки
OpenAI compatibility в Ollama описывает base_url, chat completions, responses, tools и поле reasoning_effort для моделей с режимом рассуждения.
Anthropic compatibility в Ollama показывает, как агент с Anthropic API переключается на local endpoint через переменные окружения.
FAQ по локальной работе Ollama содержит настройки OLLAMA_HOST, OLLAMA_CONTEXT_LENGTH, OLLAMA_NO_CLOUD и OLLAMA_KEEP_ALIVE.
Modelfile Reference объясняет PARAMETER num_ctx, SYSTEM, TEMPLATE и MESSAGE для создания локальной модели с нужным поведением.
urllib.request позволяет отправить POST запрос к локальному API без стороннего Python пакета.