Спор Ollama vs llama.cpp для сервера LLM обычно решают по комментариям на форуме, а не по замерам. Недавно Selectel выпустил на Хабре сравнение двух рантаймов на видеокарте RTX 4090. У большинства инженеров такого железа под рукой нет, а механизм за цифрами воспроизводится и на обычном CPU. Ниже разберём выводы исходной статьи, посмотрим, как устроены оба рантайма, и напишем свой замерщик задержек, который одинаково работает с обоими серверами.
О чём статья Selectel и какие выводы она делает
Автор начинает с короткой истории. Ollama появилась в 2023 году как обёртка над llama.cpp, в 2025 году её разработчики написали собственный движок поверх GGML, а в 2026 году Ollama вернулась к llama.cpp для работы с файлами формата GGUF. Дальше автор поднимает на облачном сервере с RTX 4090 одну и ту же квантованную модель Gemma 4 26B A4B (Q4_0). Это MoE-версия, в которой на каждый токен активируется около 4 млрд из 26 млрд параметров. Сначала модель запускается через Ollama, затем через собственный сервер проекта llama.cpp, то есть llama-server. Для замеров используется утилита GuideLLM, а тест состоит из 30 запросов по 32 тысячи входных токенов и 256 выходных. Оба сервера работают с одним и тем же файлом модели и контекстом 33 792 токена, а llama.cpp, по словам автора, никак не тюнили, сравнение идёт «из коробки».
Автор сравнивает четыре метрики. TTFT (Time To First Token) показывает время до первого токена ответа. ITL (Inter-Token Latency) это задержка между последующими токенами. Output tokens/s описывает скорость генерации, а request latency означает полное время запроса.
Результаты у двух рантаймов близки. На одном запросе Ollama выдаёт 34,1 токена в секунду, llama-server выдаёт 35,2, медианное время запроса составляет 7,7 и 7,5 секунды. При двух параллельных запросах задержка вырастает примерно до 14 секунд у обоих, а throughput поднимается до 37,5 и 38,3 токена в секунду. При четырёх запросах llama-server опережает Ollama заметнее, 39,6 против 36,8 токена в секунду при задержке 27,0 против 28,8 секунды. Расход видеопамяти практически одинаков и растёт с параллелизмом, от 16,5 до 19,3 ГБ. Вероятная причина в том, что на каждый слот нужен свой участок KV-кэша, но это наше предположение, а не проверенный вывод автора.
Вывод автора такой. Удобство Ollama стоит нескольких процентов производительности, а при работе преимущественно на CPU или при необходимости гибкой настройки имеет смысл разобраться с llama-server. Единственным минусом Ollama он называет долгий холодный старт после выгрузки модели из памяти и замечает, что это можно настроить.
У исходника есть ограничение. Цифры получены на GPU и на CPU не переносятся, поэтому сравнивать можно только характер зависимости, а не абсолютные значения. Поэтому ниже мы считаем TTFT и ITL сами по чанкам стрима, одним и тем же кодом для обоих серверов.
Как устроены Ollama и llama-server под капотом
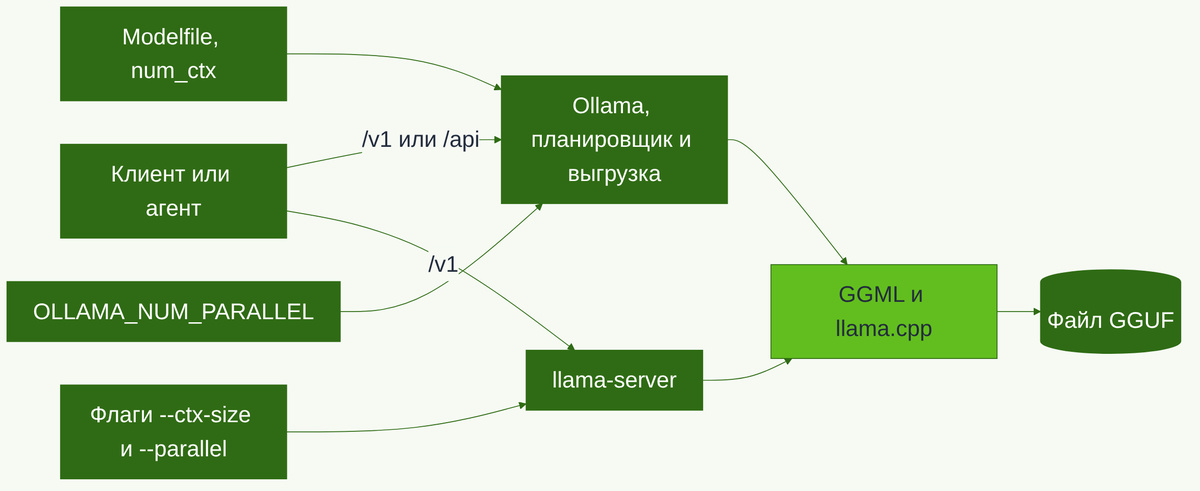
Оба сервера используют одни и те же вычислительные ядра (GGML) и читают формат GGUF. Различается то, что построено вокруг ядер. Ollama добавляет реестр моделей, управление жизненным циклом и CLI, похожий на Docker (pull, run, rm, ps). llama-server остаётся тонким HTTP-сервером, у которого каждая настройка вынесена в отдельный флаг командной строки.
Стек запроса и места настройки
На схеме показаны две ветки. В Ollama запрос проходит через слой управления моделью, где живут Modelfile и выгрузка, и только потом попадает в GGML. В llama-server клиент обращается к серверу напрямую, а контекст и параллелизм задаются флагами запуска.
В нашем прогоне Ollama забирает модель с Hugging Face командой ollama pull, где имя начинается с префикса Hugging Face, затем идут организация и репозиторий, а квант указывается через двоеточие. llama-server делает то же самое флагом -hf, при этом по README квант по умолчанию Q4_K_M, а если такого файла в репозитории нет, берётся первый файл. Для локальных файлов у llama-server есть флаг -m.
Оба сервера в нашем прогоне отвечают на запросы к /v1/chat/completions, поэтому для клиента разница сводится к смене адреса и имени модели. По README llama-server дополнительно поддерживает Anthropic Messages API, непрерывную пакетную обработку (continuous batching), вызов инструментов (function calling) и встроенный веб-интерфейс. Про Ollama мы опираемся на исходную статью и на собственный прогон.
Сравнение рантаймов
В таблице собраны только пункты, подтверждённые исходной статьёй, README llama-server или нашим стендом. Последние две строки это значения tok/s из двух прогонов замерщика, которые описаны ниже.
| Критерий | Ollama | llama-server |
|---|---|---|
| Установка | Готовый контейнер ollama/ollama, как на нашем стенде | Готовый образ, как на нашем стенде, либо сборка из исходников по документации проекта |
| Источник моделей | Команда ollama pull, на стенде с префиксом Hugging Face в имени модели | Флаг -hf для Hugging Face, флаг -m для локального файла |
| Контекст | Параметр num_ctx в Modelfile, по словам автора исходника через API он не задаётся | Флаг —ctx-size, по README по умолчанию берётся из модели |
| Параллелизм | Переменная OLLAMA_NUM_PARALLEL, в исходной статье и на нашем стенде равна 2 | Флаг —parallel, по README по умолчанию число слотов определяется автоматически, на нашем стенде задано 2; непрерывная пакетная обработка включена по умолчанию |
| API в нашем прогоне | OpenAI-совместимый /v1/chat/completions | OpenAI-совместимый /v1/chat/completions, по README также Anthropic Messages API |
| tok/s на CPU при одном запросе, первый и второй прогон | 20,1 и 19,1 | 22,3 и 18,0 |
| tok/s на CPU при двух запросах, первый и второй прогон | 23,5 и 28,1 | 27,2 и 27,2 |
Таблица показывает, что на CPU стабильного победителя по скорости нет. В первом прогоне llama-server быстрее на обоих уровнях, 22,3 против 20,1 при одном запросе и 27,2 против 23,5 при двух. Во втором прогоне различия лежат в пределах разброса, и лидера нет, 19,1 против 18,0 при одном запросе и 28,1 против 27,2 при двух. Между прогонами Ollama изменилась на 5 процентов при одном запросе (20,1 и 19,1) и на 20 процентов при двух (23,5 и 28,1). У llama-server при одном запросе разница около 19 процентов (22,3 и 18,0), а при двух запросах значения совпали, 27,2 и 27,2. Поэтому разброс замеров на шести-восьми запросах сопоставим с разницей между серверами, и честный вывод для этого стенда такой, что по скорости генерации они сравнимы, а выбирать стоит по другим признакам. Ollama удобнее там, где важна простота, потому что модель подтягивается одной командой. llama-server прозрачнее в настройках, потому что каждый параметр виден в командной строке. По данным исходника, на GPU при четырёх параллельных запросах он немного опережает Ollama по throughput, а на одном и двух запросах разница минимальна.
Параллелизм, контекст и память
В исходной статье параллелизм включается двумя разными способами. В Ollama через systemctl edit добавляется переменная окружения OLLAMA_NUM_PARALLEL=2 с последующим перезапуском сервиса. В llama-server задаётся —parallel 2, и сервер заводит два слота. Без этого флага, по README, число слотов определяется автоматически, а непрерывная пакетная обработка включена. Фактическое число слотов на нашем стенде мы по логам llama-server не проверяли и опираемся на заданный флаг.
Контекст тоже настраивается по-разному. Для Ollama автор создаёт Modelfile со строкой PARAMETER num_ctx 33792 и собирает отдельный alias командой ollama create. Для llama-server в одиночном тесте достаточно —ctx-size 33792. В параллельных тестах автор вместо этого использует флаг —kv-unified-per-slot 33792. По README он ограничивает контекст на слот, а при заданном значении без —ctx-size размечает общий пул KV-кэша под n_parallel умноженное на N. На нашем стенде мы задаём простой —ctx-size 4096. Сам механизм показывает, что память под KV-кэш зависит от числа слотов, что согласуется с ростом VRAM в исходных замерах.
Практический смысл для читателя такой. Если вы подключаете к серверу один агент, хватает одного слота и небольшого контекста. Если к серверу обращаются несколько сотрудников или несколько агентов, параллелизм нужно задавать явно и закладывать память под KV-кэш каждого слота, иначе запросы выстроятся в очередь.
Агент с открытой моделью вместо облачной
Любой OpenAI-совместимый клиент подключается к локальному серверу сменой адреса. По исходной статье Ollama слушает loopback-адрес 127.0.0.1 на порту 11434, и на нашем стенде этот порт задан в compose.yaml. У llama-server порт задаётся флагом —port. В README умолчанием указан порт 9931, в других версиях значение может отличаться, поэтому мы задаём 8080 явно, как в нашем compose.yaml, и используем путь /v1. Ключ API может быть любой строкой. Подробнее о построении агентов вокруг открытых моделей рассказывает курс AI-агенты для оптимизации бизнес-процессов.
Практика, единый замерщик TTFT, ITL и tokens/s для двух серверов на CPU
Мы запустим обе реализации с одним и тем же GGUF, Qwen3 0.6B в кванте Q4_K_M, на CPU, и измерим метрики по стриму одним и тем же кодом. Оба сервера работают с двумя слотами, поэтому уровни параллелизма 1 и 2 сравнимы между собой. Образ llama-server на стенде взят с плавающим тегом server, поэтому версия llama.cpp в нём соответствует сборке на момент загрузки образа, и числа ниже относятся именно к ней. Для воспроизводимости в своём проекте закрепите конкретный тег сборки или digest образа в compose.yaml.
Стенд
Файл compose.yaml поднимает Ollama, llama-server и вспомогательный контейнер с Python для замерщика. Порты опубликованы только на 127.0.0.1, суммарный лимит памяти составляет 5 ГБ.
# compose.yaml · ollama/ollama 0.40.13 · ghcr.io/ggml-org/llama.cpp:server (плавающий тег) · python 3.13.18
services:
  ollama:
    image: ollama/ollama:0.40.13
    mem_limit: 2g
    environment:
      OLLAMA_NUM_PARALLEL: "2"
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ollama_data:/root/.ollama
  llamacpp:
    image: ghcr.io/ggml-org/llama.cpp:server
    mem_limit: 2g
    command:
      - "-hf"
      - "unsloth/Qwen3-0.6B-GGUF:Q4_K_M"
      - "--host"
      - "0.0.0.0"
      - "--port"
      - "8080"
      - "--ctx-size"
      - "4096"
      - "--parallel"
      - "2"
      - "--alias"
      - "qwen3-0.6b"
    ports:
      - "127.0.0.1:8080:8080"
    volumes:
      - llama_cache:/root/.cache
  bench:
    image: python:3.13.18-slim-bookworm
    mem_limit: 1g
    working_dir: /app
    volumes:
      - .:/app
    command: [".venv/bin/python", "bench.py"]
    profiles: ["tools"]
volumes:
  ollama_data:
  llama_cache:
# requirements.txt
httpx==0.28.1
Скрипт run.sh поднимает серверы, дожидается готовности Ollama, тянет модель, создаёт виртуальное окружение и запускает замерщик.
#!/usr/bin/env bash
# run.sh · Docker Compose · Ollama 0.40.13 · Python 3.13.18
set -euo pipefail
docker compose up -d ollama llamacpp
until docker compose exec -T ollama ollama list >/dev/null 2>&1; do sleep 2; done
docker compose exec -T ollama ollama pull hf.co/unsloth/Qwen3-0.6B-GGUF:Q4_K_M
rm -rf .venv
python3 -m venv .venv
.venv/bin/pip install -q -r requirements.txt
.venv/bin/python bench.py
Замерщик
Основная функция one_request открывает стрим к /v1/chat/completions и фиксирует момент прихода каждого чанка с текстом. Один чанк мы считаем примерно одним токеном, это приближение, а не точный подсчёт токенов. В промпт добавлена метка /no_think, чтобы Qwen3 отвечал без длинного блока рассуждений. В тексте чанка проверяются поля content, reasoning_content и reasoning, потому что серверы могут отдавать рассуждения в разных полях. TTFT считается от отправки запроса до первого чанка, ITL это медиана интервалов между соседними чанками, а tokens/s считается суммарно по всем запросам уровня за время всего прогона.
# bench.py · httpx 0.28.1 · Python 3.13.18 · Ollama 0.40.13 · llama.cpp server
import asyncio
import json
import time
from statistics import median

import httpx

SERVERS = {
    "ollama": ("http://127.0.0.1:11434", "hf.co/unsloth/Qwen3-0.6B-GGUF:Q4_K_M"),
    "llama-server": ("http://127.0.0.1:8080", "qwen3-0.6b"),
}
PROMPT = "/no_think Объясни в трёх предложениях, чем сервер инференса отличается от библиотеки."
MAX_TOKENS = 96
REQUESTS = 6


async def one_request(client, base, model, max_tokens=MAX_TOKENS):
    body = {
        "model": model,
        "messages": [{"role": "user", "content": PROMPT}],
        "stream": True,
        "temperature": 0,
        "max_tokens": max_tokens,
    }
    start = time.perf_counter()
    stamps = []
    async with client.stream("POST", f"{base}/v1/chat/completions", json=body) as resp:
        resp.raise_for_status()
        async for line in resp.aiter_lines():
            if not line.startswith("data:"):
                continue
            payload = line[5:].strip()
            if payload == "[DONE]":
                break
            choices = json.loads(payload).get("choices") or []
            if not choices:
                continue
            delta = choices[0].get("delta") or {}
            text = delta.get("content") or delta.get("reasoning_content") or delta.get("reasoning")
            if text:
                stamps.append(time.perf_counter())
    if not stamps:
        raise RuntimeError("пустой ответ")
    return start, stamps


async def warmup(client, base, model, timeout=900):
    deadline = time.monotonic() + timeout
    while True:
        try:
            await one_request(client, base, model, max_tokens=8)
            return
        except (httpx.HTTPError, RuntimeError, json.JSONDecodeError):
            if time.monotonic() > deadline:
                raise
            await asyncio.sleep(3)


async def run_level(client, base, model, concurrency, total=REQUESTS):
    sem = asyncio.Semaphore(concurrency)

    async def worker():
        async with sem:
            return await one_request(client, base, model)

    wall_start = time.perf_counter()
    results = await asyncio.gather(*(worker() for _ in range(total)))
    wall = time.perf_counter() - wall_start
    ttft = [s[0] - t0 for t0, s in results]
    latency = [s[-1] - t0 for t0, s in results]
    gaps = [b - a for _, s in results for a, b in zip(s, s[1:])]
    tokens = sum(len(s) for _, s in results)
    return {
        "ttft": median(ttft) * 1000,
        "itl": median(gaps) * 1000,
        "latency": median(latency) * 1000,
        "tps": tokens / wall,
    }


def show(rows):
    head = ["сервер", "c", "TTFT, мс", "ITL, мс", "запрос, мс", "tok/s"]
    print(" | ".join(h.ljust(14) for h in head))
    for name, c, m in rows:
        cells = [name, str(c), f"{m['ttft']:.0f}", f"{m['itl']:.1f}", f"{m['latency']:.0f}", f"{m['tps']:.1f}"]
        print(" | ".join(x.ljust(14) for x in cells))


async def main():
    rows = []
    async with httpx.AsyncClient(timeout=httpx.Timeout(300.0)) as client:
        for name, (base, model) in SERVERS.items():
            await warmup(client, base, model)
            for c in (1, 2):
                rows.append((name, c, await run_level(client, base, model, c)))
    show(rows)


if __name__ == "__main__":
    asyncio.run(main())
сервер         | c              | TTFT, мс       | ITL, мс        | запрос, мс     | tok/s
ollama         | 1              | 220            | 43.6           | 3215           | 20.1
ollama         | 2              | 380            | 75.5           | 5308           | 23.5
llama-server   | 1              | 200            | 40.6           | 2844           | 22.3
llama-server   | 2              | 350            | 65.4           | 4759           | 27.2
Серверы измеряются строго по очереди, а не одновременно, чтобы они не конкурировали за процессорные ядра. Качественно картина та же, что в исходной статье. При переходе с одного запроса на два время отдельного запроса растёт заметно, у Ollama с 3,2 до 5,3 секунды, у llama-server с 2,8 до 4,8 секунды, а суммарный throughput растёт меньше, чем вдвое, с 20,1 до 23,5 и с 22,3 до 27,2 токена в секунду. TTFT при этом остаётся небольшим, 200-380 мс, потому что промпт короткий, а не 32 тысячи токенов, как у автора исходника. В этом прогоне llama-server впереди на обоих уровнях, но в заданиях ниже мы повторим замер и увидим, что на шести-восьми запросах такой отрыв не воспроизводится. Числа относятся только к этому стенду и к шести запросам на каждый уровень, а не к вашему серверу.
Задания
Задачи используют уже готовый bench.py, поэтому запускаются в том же контейнере с теми же зависимостями.
Задание 1. Расширьте прогон до уровней параллелизма 1, 2 и 4 при двух слотах на сервере. Какой эффект даёт четвёртый запрос, если слотов всего два?
Решение
Достаточно вызвать run_level с тремя значениями параллелизма и восемью запросами на уровень, чтобы число запросов делилось на каждый из уровней.
# sweep.py · httpx 0.28.1 · Python 3.13.18
import asyncio

import httpx

from bench import SERVERS, run_level, show, warmup


async def main():
    rows = []
    async with httpx.AsyncClient(timeout=httpx.Timeout(600.0)) as client:
        for name, (base, model) in SERVERS.items():
            await warmup(client, base, model)
            for c in (1, 2, 4):
                rows.append((name, c, await run_level(client, base, model, c, total=8)))
    show(rows)


if __name__ == "__main__":
    asyncio.run(main())
сервер         | c              | TTFT, мс       | ITL, мс        | запрос, мс     | tok/s
ollama         | 1              | 218            | 44.7           | 3419           | 19.1
ollama         | 2              | 347            | 64.5           | 4488           | 28.1
ollama         | 4              | 5104           | 66.1           | 9483           | 27.2
llama-server   | 1              | 256            | 47.0           | 3347           | 18.0
llama-server   | 2              | 349            | 64.9           | 4621           | 27.2
llama-server   | 4              | 4988           | 66.6           | 9476           | 25.0
Четвёртый запрос при двух слотах ничего не ускоряет, а только создаёт очередь. TTFT вырастает примерно с 350 мс до 5000 мс, то есть более чем на порядок, у обоих серверов. Это похоже на очередь, потому что два лишних запроса, вероятно, ждут освобождения слота, а около 4,5 секунды это время полного запроса на уровне 2. Загрузку слотов мы напрямую не измеряли, поэтому это объяснение остаётся правдоподобным, но не доказанным. ITL при этом почти не меняется, 66 мс против 65 мс, так как одновременно декодируются те же два запроса. Throughput не растёт, у Ollama он равен 27,2 против 28,1 токена в секунду, у llama-server падает с 27,2 до 25,0, а время запроса удваивается до 9,5 секунды. Заметим ещё, что во втором прогоне уровни 1 и 2 дали другие числа, чем в первом, и на уровне 1 Ollama и llama-server различаются на 19,1 и 18,0 токена в секунду. Значит, разница между серверами на CPU находится в пределах разброса замеров.
Задание 2. Задайте обоим серверам один и тот же вопрос с temperature=0, меняя только адрес и имя модели, и проверьте, совпали ли ответы.
Решение
Один и тот же клиентский код обращается к двум адресам. Совпадение ответов не гарантировано, потому что рантаймы могут по-разному применять шаблон чата и сэмплирование, поэтому сравниваем и печатаем оба результата.
# same_answer.py · httpx 0.28.1 · Python 3.13.18
import asyncio

import httpx

from bench import SERVERS, warmup

QUESTION = "/no_think Назови столицу России одним словом."


async def ask(client, base, model):
    resp = await client.post(
        f"{base}/v1/chat/completions",
        json={
            "model": model,
            "messages": [{"role": "user", "content": QUESTION}],
            "stream": False,
            "temperature": 0,
            "max_tokens": 40,
        },
    )
    resp.raise_for_status()
    return resp.json()["choices"][0]["message"]["content"]


async def main():
    answers = {}
    async with httpx.AsyncClient(timeout=httpx.Timeout(300.0)) as client:
        for name, (base, model) in SERVERS.items():
            await warmup(client, base, model)
            answers[name] = await ask(client, base, model)
            print(name, repr(answers[name]))
    print("совпали:", len(set(answers.values())) == 1)


if __name__ == "__main__":
    asyncio.run(main())
ollama 'Россия — столица — **Россия**.'
llama-server 'Столица России — это **Москва**.'
совпали: False
Ответы не совпали, и ответ Ollama к тому же неверный, тогда как llama-server назвал Москву. Причину этот прогон не доказывает. Возможны разный шаблон чата, разная обработка метки /no_think или просто слабость модели на 0,6 млрд параметров, и отделить эти версии друг от друга одним запросом нельзя. Практический вывод в том, что при смене рантайма нужно перепроверять качество ответов, а не только скорость.
Задание 3. Измерьте холодный старт Ollama. Выгрузите модель и сравните TTFT первого запроса после выгрузки с TTFT прогретой модели.
Решение
Для выгрузки мы обращаемся к родному API Ollama с параметром keep_alive, равным нулю, то есть просим сервер выгрузить модель из памяти. Затем делаем паузу в три секунды и снова измеряем TTFT. Сам факт выгрузки скрипт не проверяет, его можно подтвердить командой ollama ps внутри контейнера, а о нём мы судим по росту TTFT. Аналогичный замер для llama-server в статье не делался.
# cold.py · httpx 0.28.1 · Python 3.13.18 · Ollama 0.40.13
import asyncio

import httpx

from bench import SERVERS, one_request, warmup


async def ttft_ms(client, base, model):
    start, stamps = await one_request(client, base, model, max_tokens=16)
    return (stamps[0] - start) * 1000


async def main():
    base, model = SERVERS["ollama"]
    async with httpx.AsyncClient(timeout=httpx.Timeout(600.0)) as client:
        await warmup(client, base, model)
        warm = await ttft_ms(client, base, model)
        await client.post(f"{base}/api/generate", json={"model": model, "keep_alive": 0})
        await asyncio.sleep(3)
        cold = await ttft_ms(client, base, model)
    print(f"TTFT прогретой модели, мс: {warm:.0f}")
    print(f"TTFT после выгрузки, мс: {cold:.0f}")


if __name__ == "__main__":
    asyncio.run(main())
TTFT прогретой модели, мс: 411
TTFT после выгрузки, мс: 3050
После выгрузки первый токен приходит за 3050 мс против 411 мс у прогретой модели, то есть примерно в 7,4 раза дольше. Это согласуется с замечанием автора исходника о долгом холодном старте, но один замер на модели в 0,6 млрд параметров ничего не доказывает. Для крупных моделей загрузка, скорее всего, будет заметно дольше, но этот прогон такого не проверял.
Если вам нужно не только измерять сервер, но и выводить такие решения в продакшен вместе с мониторингом и версионированием моделей, пройдите курс по MLOps и внедрению ML-решений.